直接一个明确的动作
从一个主要动作和一个镜头指令开始制作短片段。说明哪些内容应保持不变。本课程使用车站场景来练习这种方法。
你将学到什么
- 主体运动与镜头运动的区别,以及为什么模型需要分别说明它们。
- 清晰运动提示词的三句式结构。
- 如何选择时长,以及何时值得设置结束帧。
- 何时停止描述镜头运动,改用参考来展示。
开始之前
从一个面部和构图已经合适的静态图像开始。在本练习中,使用旅行者从手表抬头看向红色雨伞的那张。参见生成视频了解相关操作。
给这个镜头一个故事目的:旅行者注意到雨伞。
步骤 1:将主体与镜头分开
每个动态画面都有两种运动,观众对它们的解读方式不同。
- 主体运动是画面中的人和物体所做的动作:她转头、火车进站、雨伞滚动。它承载着故事节拍。
- 镜头运动引导注意力。摇镜向左或向右转动;俯仰向上或向下转动。推进靠近主体;拉远远离主体。跟镜沿着主体移动。静止镜头保持不动。
在写提示词之前,将这两者分行写下来。对于转头镜头:
- 主体:她从手表抬起头,慢慢地将头转向雨伞。
- 镜头:静止。
如果主体的动作不清楚,请重新审视场景。如果镜头需要多个运动,在组合之前先分别测试它们。
第 2 步:用三句话编写提示词
编写三句话:主体的动作、镜头的动作以及应保持不变的内容。
- 主体和动作,加上节奏词。 "她从手表上抬起头,慢慢地将头转向长凳上的红色雨伞。"
- 镜头,作为一条指令。 "静止镜头,锁定构图。" 或者,如果镜头需要,"缓慢推进至她的脸部。"
- 哪些内容不能改变。 "平台、照明和构图保持不变。"
使用可见的指令而不是单独的情绪标签。对于分阶段的动作,说明顺序:"首先她抬起头,然后转身。"
将这三句话粘贴到 Image to Video 节点下方面板的提示词字段中。
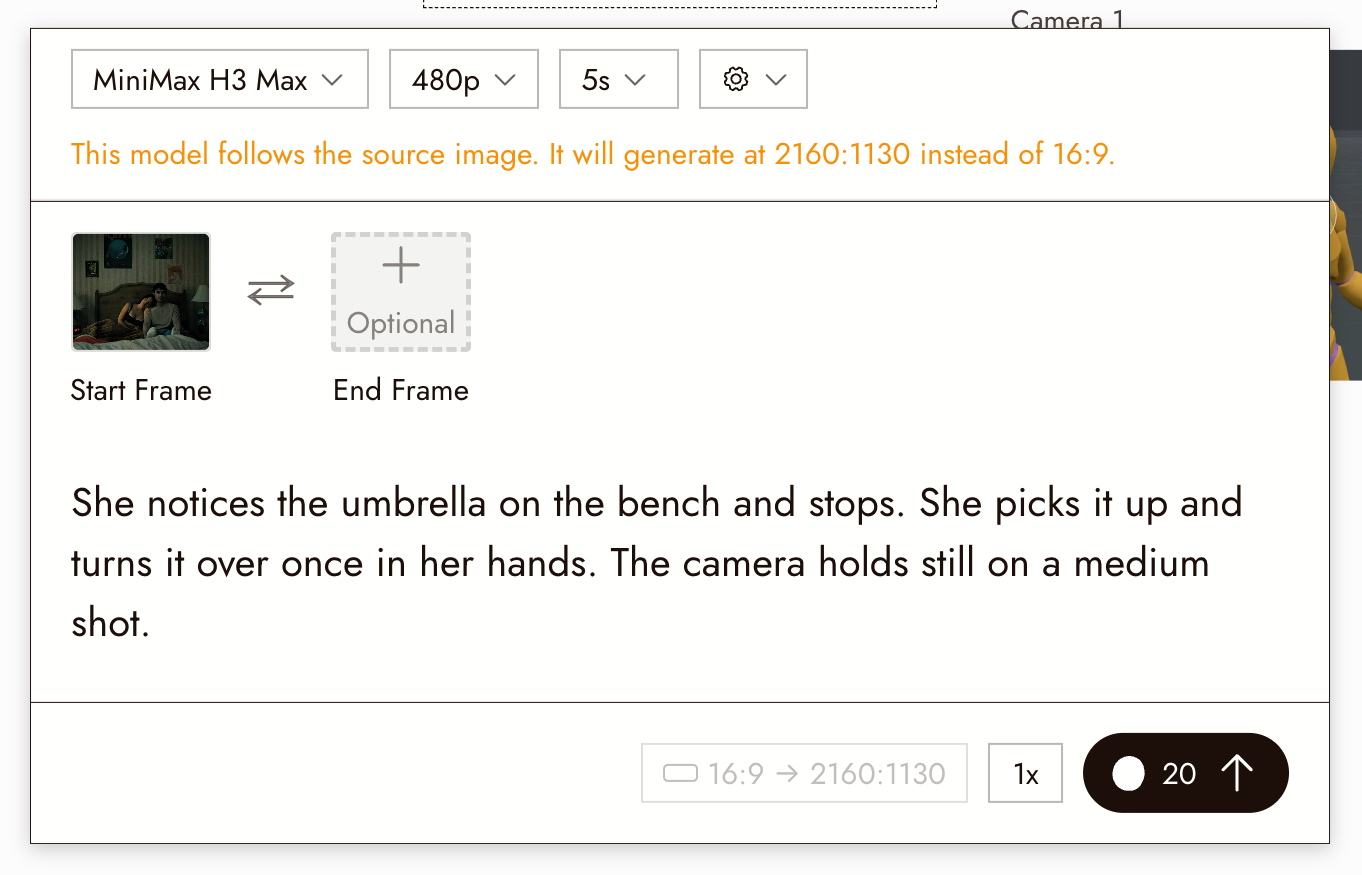
第 3 步:选择容纳动作的最短时长
选择适合动作的最短可用时长。额外的时间可能会引入不需要的动作。之后修剪多余时间;请参阅 Trim and split。
如果模型支持 End Frame,请附上一张显示预期结尾的静态画面,例如她的目光停留在雨伞上。它会引导终点,但不能保证帧之间的确切动作。
在生成之前检查 Run 上的成本。在适中的分辨率下测试。如果你生成更高分辨率的拍摄,请再次查看;它可能与草稿不同。
第 4 步:进行一次三镜练习
使用相同的静态画面、时长和模型比较三个镜头。在开始之前检查所有三个的成本:
- 镜头 A,仅主体。 第 2 步的动作加上"静止镜头"。
- 镜头 B,仅镜头。 "她静止不动,看着雨伞。缓慢推进至她的脸部。其他都不变。"
- 镜头 C,两者结合。 动作和推进一起。
观看 A 看主体的动作,B 看镜头移动,C 看它们如何配合。组合动作可能会引入漂移,但可能有效。保留清晰讲述故事的镜头。
下面的片段是 Flick 驻留影片 Xenogenesis 中从一个起始帧拍摄的三个镜头,在该制作期间生成。提示词未被记录,因此请从练习的教学意义来理解:相同的静态画面,相同的 15 秒,三种不同的答案。
第 5 步:当文字不够用时,展示动作
如果文本不够用,可以提供一段视频来展示预期的动作。选择静止图像,选择视频,然后选择动作参考,或使用全能参考配合支持的图像和视频输入。3D 舞台录制可以提供相机参考。请参阅全能参考和3D 舞台导出。
有两种看起来像相机运动的情况实际上并非如此,它们有各自的工具:
- 同一场景的不同角度,用于反打或反应镜头,是静止图像:图像,然后改变角度,使用旋转、倾斜和前进滑块;请参阅相机控制。
- 在片段结束后继续动作需要新片段:使用提取帧(最后一帧)获取最后一帧,并将其用作下一个起始帧;请参阅提取帧。
AI 哪里会出错,以及为什么这样做有帮助
模糊的提示词会留下重要的选择空间。分开的指令让你更容易看出是主体、相机还是背景造成了问题。审查结果而不是假设提示词会被完全遵循。
检查结果
观看完整片段,包括最后一秒,然后检查:
- 主体执行了单一动作,按照你要求的节奏,没有其他动作。
- 相机按照第二句话所说的那样移动,仅此而已。
- 第三句话中的内容没有改变:构图、光照、面部。
- 动作在片段内开始和结束,两侧都留有一点剪辑空间。
如果出现问题
我说静止但相机动了。把相机的句子单独放在第二句,用不同的词说两遍:"静止相机,锁定构图。"缩短片段。
动作在第一秒就结束了。添加节奏词和顺序词,并将时长缩短到动作的长度。
动作过程中面部发生了变化。尝试更小的头部转动或更少的相机运动。分别测试每个来找出原因。
模型生成了新的背景。大幅度的相机运动要求静止图像中不包含的内容。减小运动幅度,或在 3D 舞台中构建运动并参考它。
相同提示词的两次拍摄产生了不同的运动。结果会有所不同。将它们与预期动作进行比较。如果你选择批量生成更多拍摄,请先检查数量和总成本。
更多症状请参阅动作不是我要求的。
下一步
- 用三个镜头讲述一个小故事,以相同的方式指导其他两个镜头。
- 生成视频,了解面板、模型和设置。
- Seedance 表演指南,更详细地指导表演。
- 在三个镜头中保持角色一致,解决同一问题的身份方面。