生成情绪
使用生成情绪将拍摄的表演转换为干净的驱动视频:一个复制演员动作和表情的纯色泥塑头部,混合第二种情绪。使用泥塑而非原始镜头来驱动视频模型,它会跟随表演而不会将演员的面部带入结果中。在浏览器中运行,无需消耗积分。
开始之前
使用面部朝向镜头的表演。无法追踪转向侧面的面部。
从平静的面部开始拍摄。泥塑会根据镜头的前几个瞬间衡量每个表情,因此如果镜头开始时就在大笑,会将笑容视为静止状态,播放时会显得更平淡。
一个片段最多可包含四个人。您一次调整一个人。
步骤
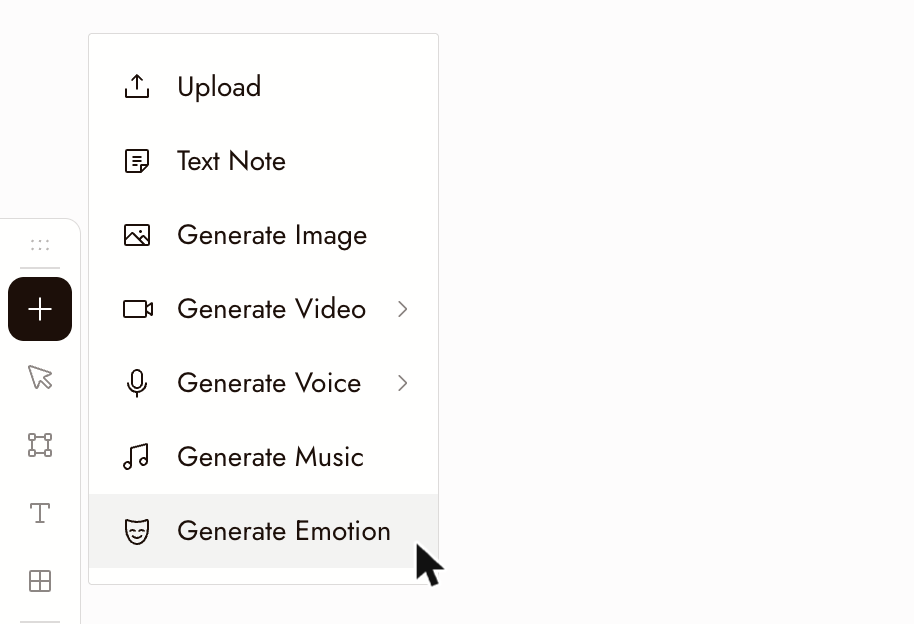
- 打开 + 工具栏并选择生成情绪,位于生成音乐下方。
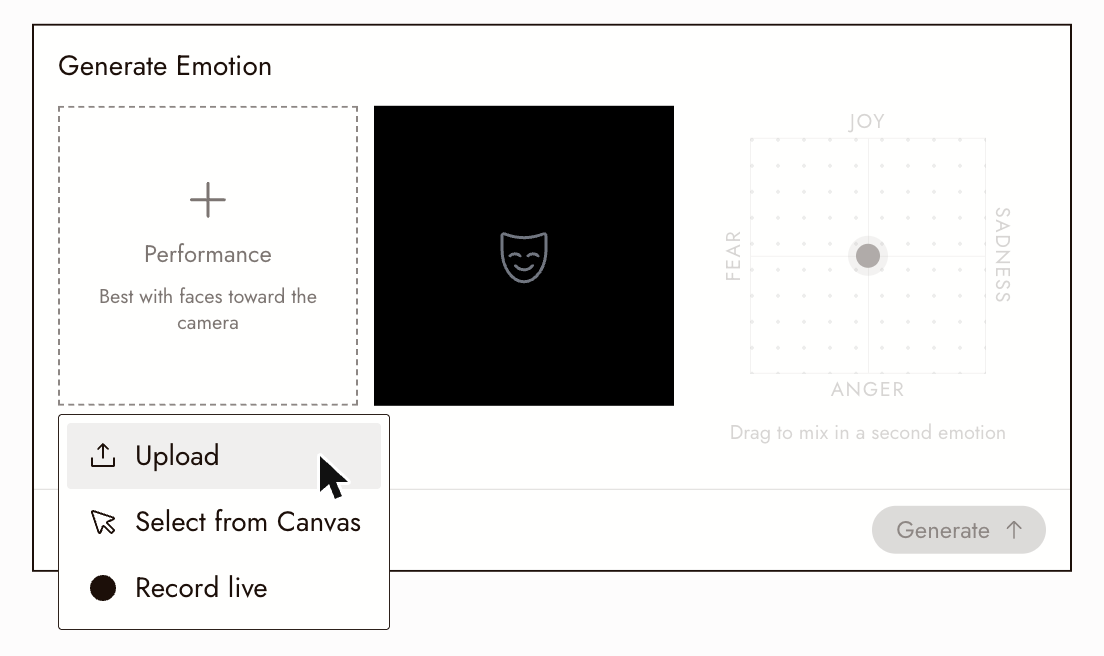
- 点击表演并选择上传、从画布选择或实时录制。对于已在画布上的视频,选择从画布选择。卡片会显示正在查找人物,同时追踪面部。上传或录制的表演仅在卡片打开时保留;只有生成的内容会被保存。
- 如果片段中有多个人,卡片会询问我们应该调整谁?并在视频中用数字标记每张脸。选择一个。如果之后想要切换,点击卡片顶部的另一张脸;圆点标记你已经生成过的人物。
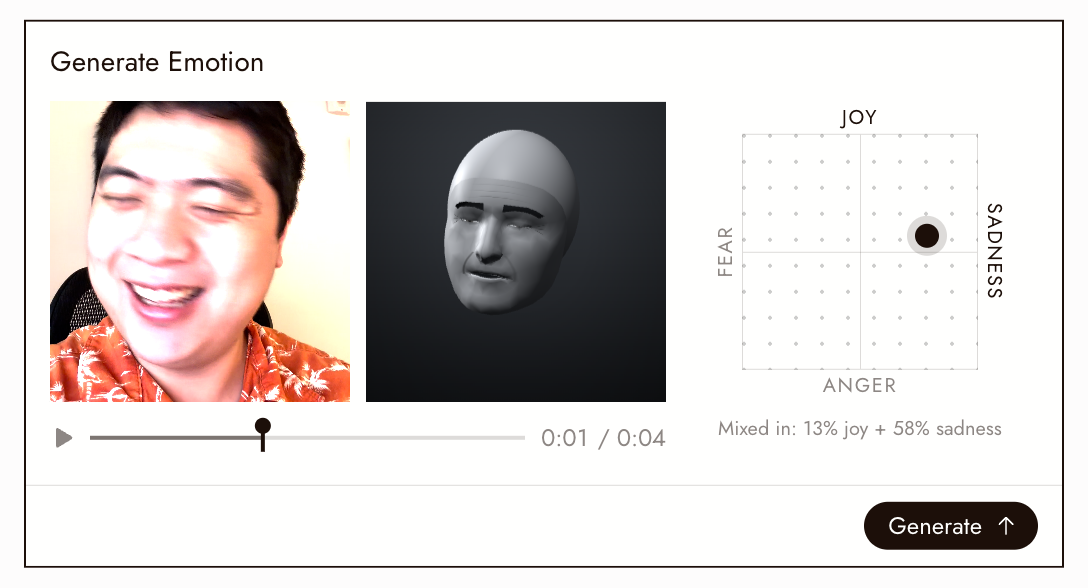
- 拖动调色板上的圆点来混入第二种情绪:喜悦向上,悲伤向右,愤怒向下,恐惧向左。离中心越远,强度越大。泥塑会随着播放的表演移动;拖动时间轴来检查任意时刻。
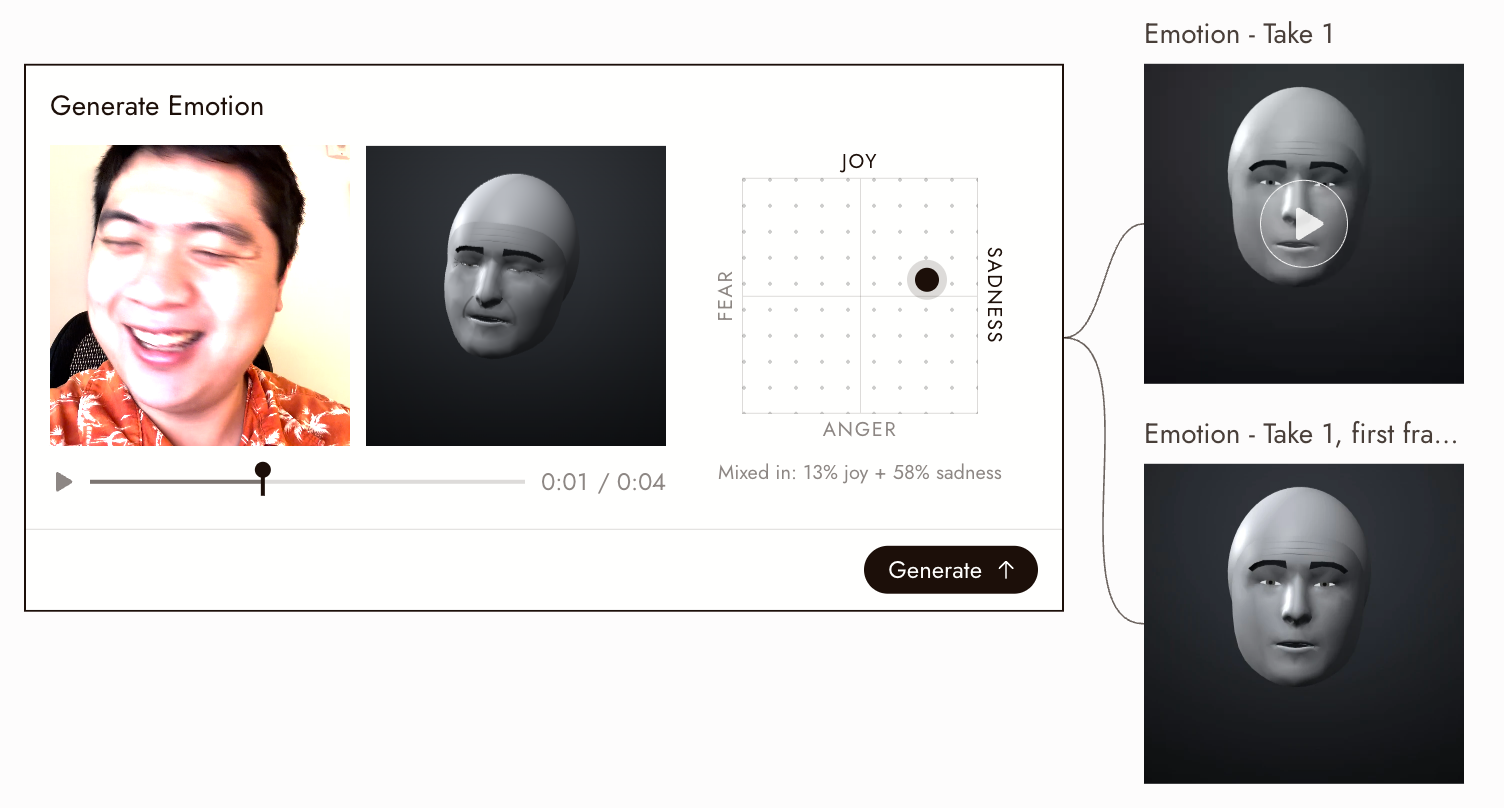
- 点击生成。卡片旁边会出现两个与之连接的节点:泥塑视频(表演的完整长度)及其第一帧图像。它们以视频命名,如"情绪 - 第 1 次拍摄"。如果有多个人,名称会说明是谁的脸,如"情绪 - 脸部 2 - 第 1 次拍摄"。实时录制没有名称,因此其片段只是"情绪"。
在视频中使用
在 全能参考中将泥塑视频附加为参考视频,将你的角色作为参考图像,并说明从每个参考中提取什么:"从 @Video1 参考面部表演和头部动作。保持 @Image1 的角色特征。"
对于有多个人的场景,为每个人生成一个片段,并在每个角色旁边提及相应片段:"@Video1 驱动左边的女性,@Video2 驱动右边的男性。"脸部 1、脸部 2 的名称可以区分这些片段。
最佳实践
面部朝向镜头。追踪跟随面部;转过身的面部会丢失,泥塑会保持静止直到它重新出现。
从平静的面部开始。表情是从拍摄的最初时刻开始测量的。
先命名视频。片段会采用视频的名称,因此命名视频可以让你稍后找到并提及这些片段。
从小幅混合开始。在确定之前,先比较小幅混合和强烈混合;原始表演应该仍然显现。
检查结果
- 泥塑在演员移动时移动,在演员面部未被检测到的地方保持静止。
- 混入的情绪可读,原始表演仍然透过它显现。
- 对于多个人,每个片段都以正确的人物命名。
如果出现问题
片段大部分时间丢失。面部追踪时间不到片段的一半。在时间轴上,虚线处泥塑保持静止。请使用面部始终朝向镜头的镜头。
可选人物中缺少某人。侧脸、非常小的面部以及在片段中出现时间少于约六分之一的人物不会被列出,并且最多只列出四个人。
同一个人被列出了两次。他们出现在剪辑的两个镜头中,位于剪切点的两侧。每个镜头都是单独追踪的;请选择你想要的那个。
表情变化很小。这个镜头开始时就已经是该表情了。请修剪至从平静的面部表情开始,然后重试。
生成功能不可用。当有多个人时,请先选择一个。如果你的浏览器无法写入视频,卡片会显示提示;请使用最新版本的桌面浏览器。
面部追踪无法运行。它需要支持 WebGL2 和 WebAssembly 的浏览器,并且开启硬件加速。
下一步
- Omni Reference 使用表情驱动视频。
- Seedance Performance Guide 用于指导表演。
- Blender to AI clip 了解另一种驱动视频的方式。