
AIっぽく見えないリアルなAI動画の作り方:実際の映画から学ぶ5つの修正
リアルなAI動画を作るには、実際のカメラが記録するものを演出します。すべてのセットを実在の場所に基づかせ、各静止画を固定されたレイアウトから構築し、光、素材、フォーカスを確認可能なものとして記述し、カメラ、演技、アクションを物理的な動作として記述します。以下は、Jaime YaoがFlickで制作した16分のフォトリアル映画In 'twixt Vowsで使用した5つの修正方法と、その背後にある実際のプロンプト、そして映画の制作費です。
AIっぽく見えないAI映画の作り方、Jaime Yaoと共に(FlickのYouTube)。以下の5つの修正は彼の5つのトリックに従っています。
プロンプト、静止画、数値はJaime Yao作「In 'twixt Vows」より(Flick Residency)。Jaimeは自身の制作舞台裏記事でこの映画のストーリーを語っています。
この手法を自分のショットで試すにはSketch to Videoを使用してください:スケッチでレイアウトを設定し、Nano Banana Proがフォトリアルなフレームを描画し、ビデオモデルがそれをアニメーション化します。
次のショットを実写のように
スケッチや静止画から始めて、レイアウトを固定し、フォトリアルなフレームと動きのあるショットに変換します。
リアルなAI動画を作る方法:見破られるポイントとその解決策
「AIスロップ」とは、モデルがプロンプトの各空白を最も平均的な推測で埋めた結果生まれる、光沢があって無個性な見た目のことです。
| 見破られるポイント | 解決策 |
|---|---|
| どこにでもありそうなセットと衣装 | 解決策1:実在の場所、時代、素材に基づく |
| プラスチックのような肌、新品のような表面 | 解決策2:それぞれの素材が経てきた歴史を描写する |
| 平坦な「シネマティック」な照明、すべてが均一に照らされている | 解決策2:光源を特定し、何が照らされ何が暗いままかを明記する |
| すべてがカミソリのようにシャープで清潔すぎる | 解決策2:焦点の被写体を指定し、最後にグレインとレンズの柔らかさを追加する |
| 重さを感じさせない滑るようなカメラ | 解決策3:操作者の歩み、揺れ、補正を記述する |
| 大げさで無個性な演技と大きく開く口 | 解決策4:感情ではなく、行動とタイミングを演出する |
| 打撃に重さがないふわふわした戦闘 | 解決策5:時間枠内で接触、力、反応を描く |
AI動画の7つの見破られるポイントと、5つの解決策のどれが各問題を解決するか。
解決策1:すべてのセット、衣装、小道具を実在のものに基づかせる
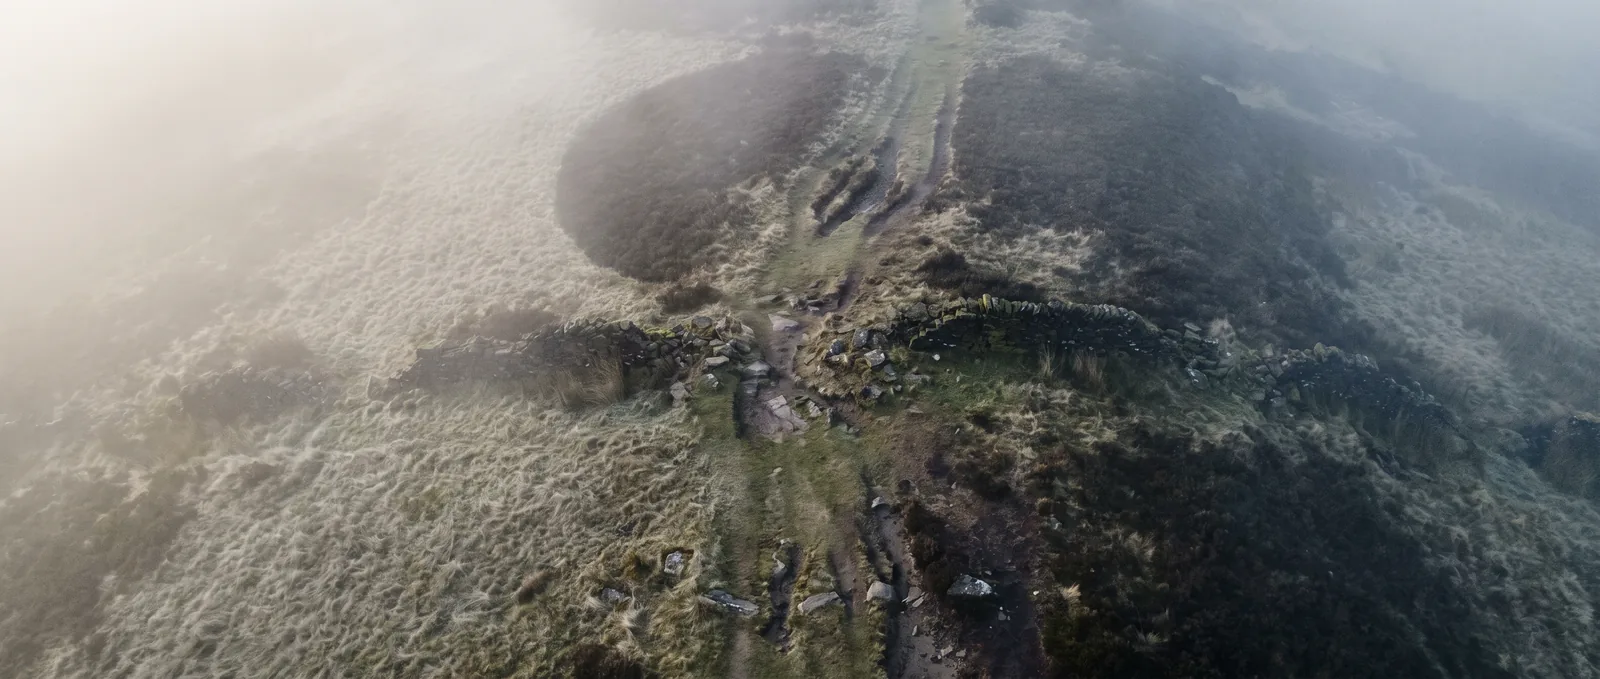
これは何か
なぜ効果的か:「ファンタジーの村」を求めると、モデルは最もよく見たことのある平均的な村を生成します。実在の場所を指定すれば、名前を挙げて確認できる具体的なディテールが得られます。
作品内では:Jaimeは映画のOutpostをハドリアヌスの長城に基づかせ、リサーチによって露出した暗い岩、浅い土壌、尾根の短い草、谷間の保護された場所のより密な植物を得ました。
取得方法
まずリサーチ:各セット、衣装、小道具について、実在の場所、時代、または物体を選びます。地形、植物、建築材料、照明に注目してください。
ハンドブックを作成:エージェントにリサーチを環境ハンドブックに変換させます:ロケーションごとに地形、植生、素材、照明をカバーする短い文書を1つ作成します。
すべてのプロンプトでそれに従う:Jaimeはエージェントにその場所を舞台とするプロンプトを書く際は常にハンドブックに「厳密に」従わせているため、土地は常に一つの特定の場所として記述されます:
注:映画のワークフローからの一文、公開された解説で引用されています
… a late-autumn upland ridge in northern Britain near Hadrian’s Wall …解決策2:各静止画を撮影されたように見せる、レンダリングされたように見せない
最もリアルなショットは静止画から始まるため、静止画がクリップの見た目を決定します。これはAI画像をリアルに見せる方法でもあります。
2.1. まずホワイトモデルとしてショットを構成する
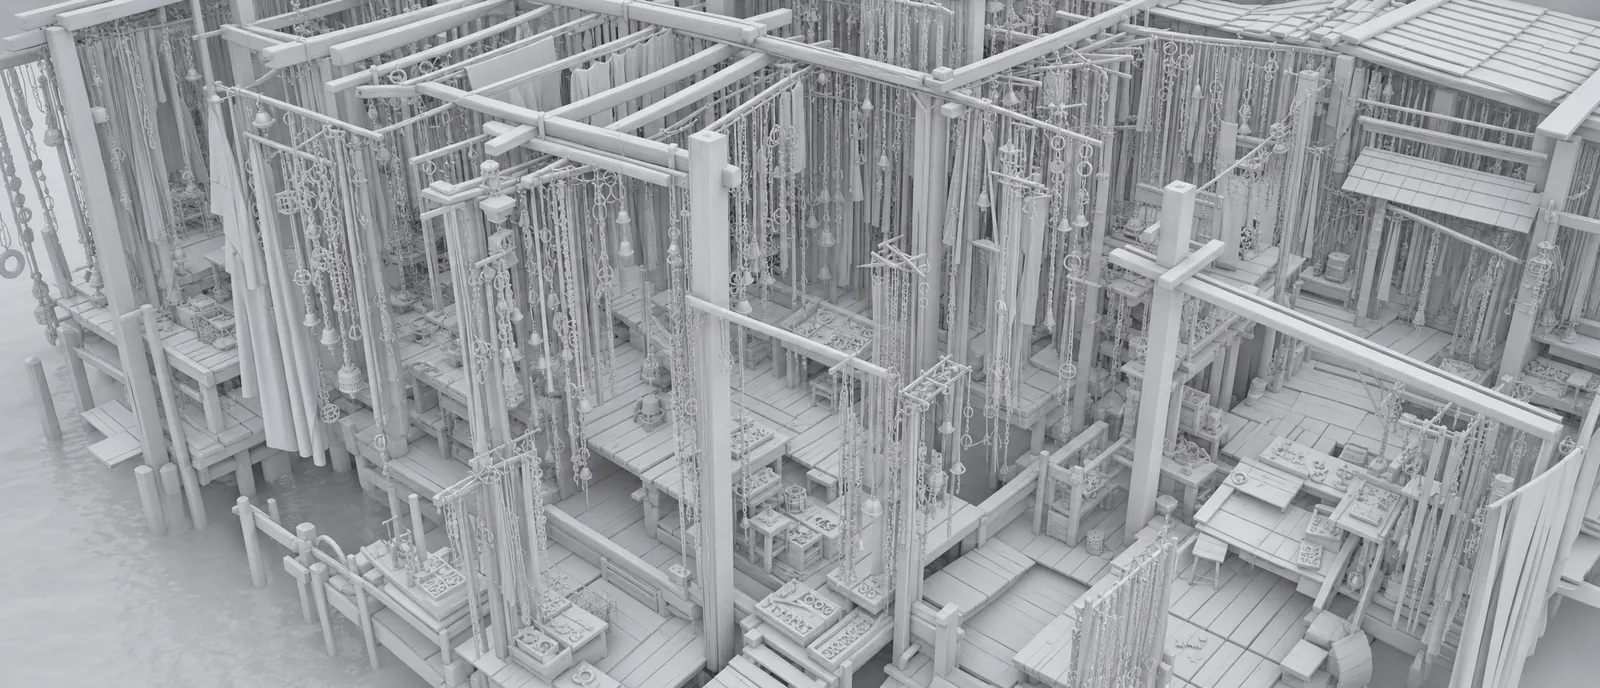
これは何か
ホワイトモデル: すべての表面が同じ白で、形状と奥行きを示すためだけに陰影をつけたショットのシンプル版(クレイレンダーとも呼ばれる)。ショットのブロッキングに使用:テクスチャが存在する前に、カメラアングルとすべての配置を決める。
なぜ最初に: JaimeがここでGPT Image 2を使用するのは、空間的な関係を理解する力が最も優れているからだという。白にすることで、完成画像で時々出る「まだらなテクスチャ」も回避できる。
取得方法
レイアウトのみをプロンプト: カメラの位置と角度、主な形状、空間のつながり方。最後にホワイトモデルの見た目を指定して、マテリアルが入り込まないようにする。描画の方が良い?バイキング映画の記事で手描きスケッチのルートを紹介している。
モデル: GPT Image 2 · 注: …でトリミング箇所を表示
3D white-model environment concept.

Semi-overhead three-quarter view. The camera is positioned above the environment and looks diagonally downward, placing the main architectural masses, platform relationships, hanging layers, and winding circulation paths within the same frame.

A half-open silversmith workshop constructed beside water. …

Unified 3D white model / clay render. All architecture, platforms, hanging elements, tools, and small objects use the same clean white modeled surface. Soft ambient shading defines volume, occlusion, spatial depth, and structural relationships.
…
2.2. レイアウトを固定し、レンダリング方法のみを変更する
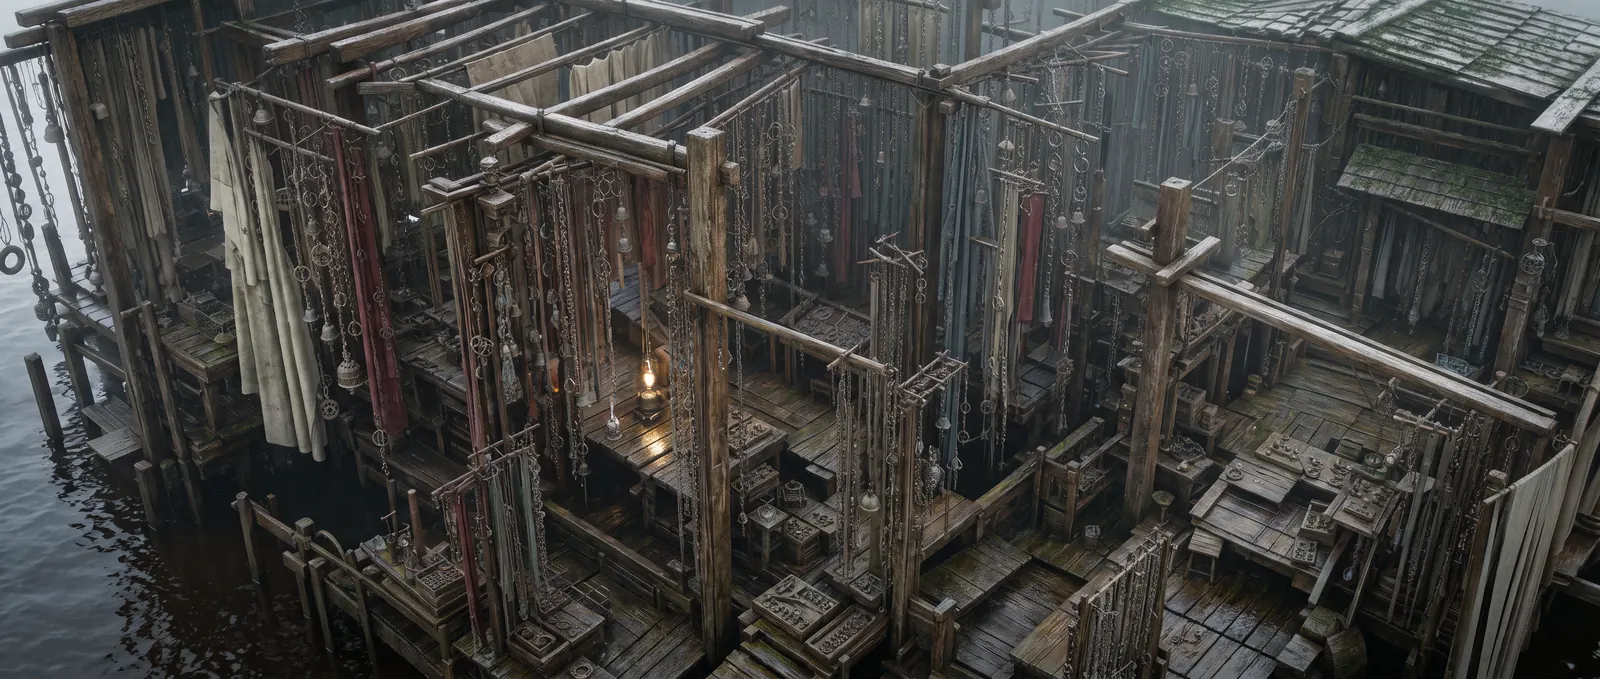
これは何か
編集ターゲット: フォトリアルなモデルには、ホワイトモデルを緩いインスピレーションとしてではなく、編集する画像として与える。Jaimeの言葉では:「より多くのオブジェクトやディテールを求めるのではなく、既存のオブジェクトのレンダリング方法を変更している」。
取得方法
まず固定: 決定した要素ごとに「Keep … 100% unchanged」の一文を:構図、カメラ、フレーミング、レイアウト。
次に変換: 変更内容を指定する一文、ここではホワイトモデルから実写への変換。
各画像に一つの役割を: ショットに人物がいる場合、キャラクターごとに一つのリファレンスを追加。トークでの鍛冶屋のショットでは、JaimeはNano Banana Proに3つの画像を与えた:レイアウトと、2人のキャラクターそれぞれのリファレンス。
モデル: Nano Banana Pro · 注: 一つのリファレンス、上記のホワイトモデルをキャンバス名で表示; …でトリミング箇所を表示
Keep composition 100% unchanged.
Keep camera position 100% unchanged.
Keep framing 100% unchanged.
Keep the entire architectural layout, platform structure, hanging-object density, spatial layering, and all object placement 100% unchanged.

Transform [Silversmith Workshop White Model] from a 3D white-model render into a live-action environment.
…
2.3. 光、マテリアル、フォーカスを確認可能な要素として記述する
これは何か
視覚的な指示: 「シネマティック」や「リアリスティック」では、モデルに確認すべきものを何も与えない。光がどこから来るか、何がそれを受けるか、何が暗いままか、各マテリアルが何を経験してきたかを述べる。Jaime:「それらは結果で確認できる具体的な関係です」。
取得方法
光: 一つの主な光源、それが当たるもの、影に落ちるもの、そしてランプのようなシーン内の小さな光。
マテリアル: それぞれの表面の歴史:湿気、摩耗、修理、酸化。その歴史が木材や金属を使い込まれたように見せます。
フォーカス: 焦点の対象と、ピントが外れる部分を指定します。鍛冶屋のショットでは、鍛冶屋がフレーム内で最も鮮明な部分ですが、「不自然にカミソリのようにシャープではない」としています。
モデル: Nano Banana Pro · 注意: 同じプロンプトの続き;省略部分は…で示しています
All timber posts, beams, platforms, hanging racks, roof edges, shelves, tables, stools, and wooden boxes become real aged wood.

The wood has been exposed to damp air and waterside conditions for a long time. Most surfaces are deep wet brown, dark gray-brown, and weathered aged brown. Timber close to the water is darker and visibly more moisture-soaked. The surfaces show natural wear, slight warping, small cracks, repeated repair marks, and reinforcement pieces of slightly different ages. …

The silverwork is mainly aged silver-gray and pale oxidized gray rather than fresh bright silver. Frequently touched and rubbed edges retain small cold metallic highlights, while recesses and gaps are darker. …

The main light source is cool gray-white natural daylight from an overcast sky, entering through the open edges and structural openings.

Timber edges near the open sides, cloth edges facing the sky, and selected silver surfaces receive brighter cool light. Deeper work areas, spaces beneath the roof, areas behind hanging layers, and the undersides of platforms remain distinctly darker.

One work area contains a very small oil lamp. The lamp creates only a small local pool of warm light, mainly touching the nearby workbench and a few silver objects.
…
効果的な言葉: 「新品の明るい銀色ではなく」という表現が、ピカピカの新品の見た目を除外します。「明確に暗いままにする」は、モデルに光を追加してはいけない場所を指示します。
2.4. グレインとレンズの欠陥は最後に追加
これは何か
仕上げのディテール: 実際のカメラには痕跡が残ります:フィルムグレイン、センサーノイズ、わずかにソフトなレンズ、エッジの色収差。Jaimeはこれらを「控えめな仕上げのディテールであり、ライティングやマテリアルの代わりにはならない」と呼んでいます。
取得方法
最後に1行: ライトとマテリアルの後に配置し、ショットが一致するようにすべてのスチルで再利用します。確認した映画のNano Banana Proプロンプト5つすべてが、グレイン、センサーノイズ、レンズのソフトネスで終わっています。
モデル: Nano Banana Pro · 注意: 同じプロンプトの最後の行
Live-action realism.
Include subtle film grain, slight sensor noise, mild lens softness, very slight chromatic aberration, soft bloom on small highlights, and natural imperfect real-camera rendering.
Wood, fabric, metal, water, and damp surfaces all have tactile, physically realistic material detail.
注意点: グレインでは弱いフレームは救えません。ライトとマテリアルが間違っていれば、グレインはノイズの多い偽物を作るだけです。
Fix 3: 人が持っているようにカメラを動かす
これは何か
ハンドヘルド: カメラはリグではなく人が持っているため、揺れ、流れ、修正されます。フレームに対してその人の体が何をするかを記述してプロンプトします。
取得方法
撮影者の位置を指定: カメラがどこにあり、それを持つ人が何をするかを述べます。ここでは彼女の前で後ろ向きに歩いています。
揺れをステップとして記述: 各ステップからの上下動、流れ、ロール、撮影者が何かを跨いだときの大きな傾き、そして修正。一時的なフォーカスのずれが回復することも許容します。
クリーンな出力を要求: カット、字幕、バックグラウンドミュージックなし。音楽は編集で追加します。
モデル: Seedance 2.5、リファレンスから動画へ · 注: 30秒、720p; より長いプロンプトの冒頭とカメラ部分; トリム箇所は…で表示
Live-action photographic realism.
No cuts.
No subtitles.
No background music.

Camera

Chest-up medium close-up from directly in front of her.
She keeps walking forward while the camera operator walks backward facing her.

Use strong, heavy handheld throughout:
irregular vertical bobbing from every backward step,
slight lateral drift, slight roll, slight height changes,
and occasional stronger dips or side shifts when the operator steps over roots or moves around trunks, then quick correction within one or two steps.
Allow one very brief natural focus slip, then quick recovery to her face.
…
プロンプトで動きを再現できない場合: Jaimeが1つのショットで必要とした90度旋回のような正確なパスには、3D Stage(カメラの動きを記録するためのFlickの3D空間)でショットをブロッキングし、その記録をカメラリファレンスとしてSeedanceに渡します。AIカメラムーブメントとAI映画の作り方に関するガイドで、両方の手順を紹介しています。
解決法4: 演技を感情ではなく行動として演出する
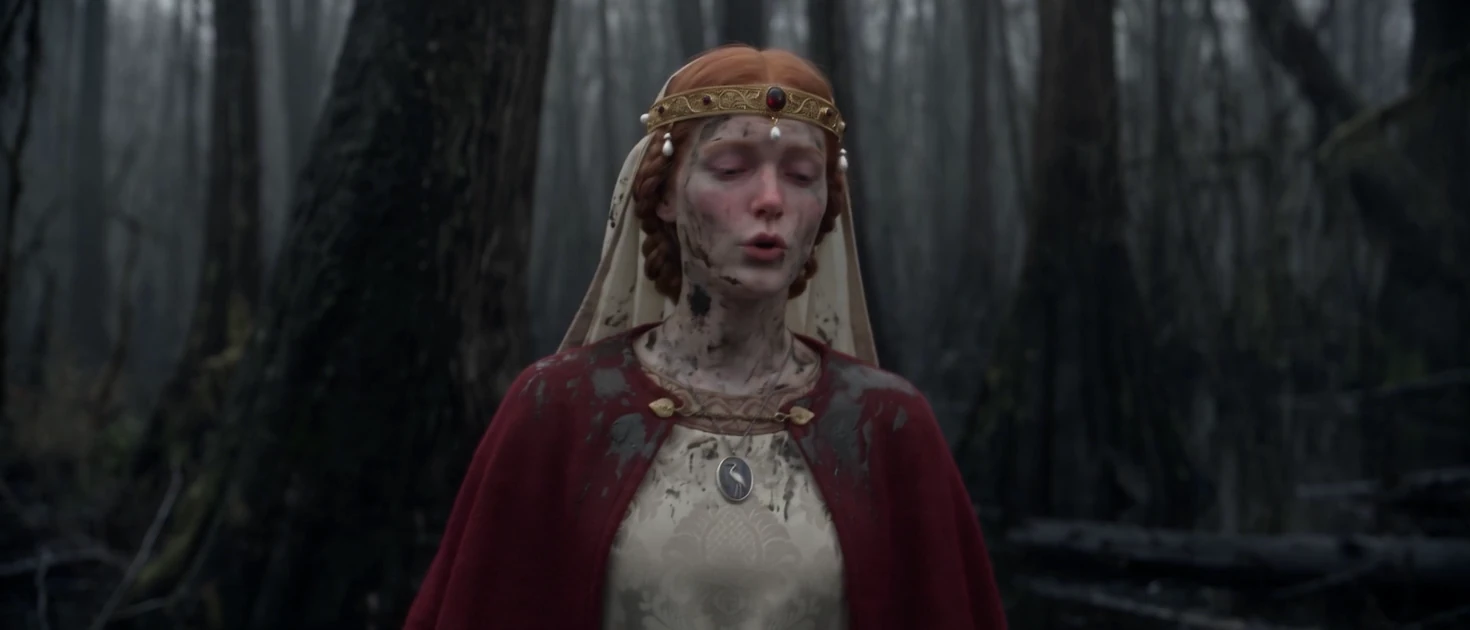
これは何か
なぜ効果的か: Jaime曰く:「問題はAIが良い演技を提供できないことではありません。十分に注意深く演出していないことです。」「悲しげに歌う」では、モデルの平均的な悲しみしか得られません。
映画内では: Lady Caerwynは寒さに震え、疲れ果て、悲しみに暮れながらも歌を続けようとしているため、プロンプトではそれが彼女の呼吸、身体、表情にどう影響するかを具体的に記述しています。
取得方法
まずキャラクターを理解する: エージェントと、彼らが誰で、何を経験し、何を望んでいるかについて話し合い、その上でどう反応するかを考えます。
身体を書き、表情は控えめに: 姿勢と動き方; 口がどれくらい開くか、視線の向き、瞬きの頻度。
セリフのタイミングを指定: 各セリフに時間枠を与え、特定の単語で何が起こるかを記述します。
音声リファレンスを与える: このテイクでは、彼女の声とアクセントのために、彼女が歌うクリップを使用しました。
モデル: Seedance 2.5、リファレンスから動画へ · 注: 解決法3と同じ30秒のテイク、演技部分; トリム箇所は…で表示
Overall performance

From the first frame she is already walking and already singing.
She does not walk upright and composed. She moves with fatigue and slight disorientation:
upper torso slightly folded inward,
shoulders low,
neck loose,
head slightly pitched forward,
chin slightly lowered.
…
While singing, do not use large mouth shapes.
The singing stays quiet, breathy, slightly unstable in pitch, uneven in phrase timing, with no stable vibrato.
Many phrase endings leak softly toward near-speech.
Lips open only as much as quiet speech,
jaw movement stays small,
…
gaze drifting toward distant points beside the camera rather than meeting the lens,
blinks infrequent and slow.
…
On "remember," raise the inner brow ends slightly more and lift both mouth corners very slightly for less than one second, with no teeth.
効果的な言葉: 「大きな口の形を使わない」と「唇は静かな会話の時と同じくらいしか開かない」が、過剰に歌っているような見た目を防ぎます。「レンズに向かってではなくカメラの横を見る」が、彼女をシーンに向けて演じるのではなく、シーンの中に留めます。
解決法5: アクションを接触、力、反応として時間枠を設けて記述する
これは何か
ビート: 浮いたような戦闘は、打撃が重みなく着地し、打たれた身体が反応しない時に起こります。各動きを4つのビートに分解します: 接触(何が何に触れるか)、力(どれくらい強く、どこから)、反応(相手の身体が何をするか)、そして次の動き。
取得方法
ビートに時間枠を与える: 3回の打撃が1秒間に起こる場合、プロンプトは各打撃、その標的、反応をその1秒の中に収める必要があります。
エージェントにビートを書かせる: タイミングを指定するだけです。Jaimeがエージェントに伝える内容:
注: Jaimeの講演から、エージェントへのリクエスト例
his attacks are extremely fast. He delivers 3 consecutive strikes in 1 second, so make sure the timing reflects that.この映画の完全なタイミング付き戦闘プロンプトは、AIで戦闘シーンを振り付ける方法のガイドに掲載されています。
エージェントにプロンプトを書かせてから自分で確認する
長く詳細なプロンプトに対するJaimeのルールは、自分で入力しないこと:「プロンプトを自分で書かないでください。エージェントに書かせてから、自分でレビューして修正してください。」
- エージェントにルールを与える。 Flickのドキュメントには、このページの各部分のガイドがあります:画像生成プロンプトガイド(静止画用)、Seedanceパフォーマンスガイド(演技用)、Seedanceアクションガイド(アクション用)。エージェントがプロンプトを書く際には、これらに従うよう依頼してください。
- リサーチ内容を渡す。 Fix 1の環境ハンドブックと、Fix 4で作成した各キャラクターの詳細。
- 生成前にすべてのプロンプトを読む。 レイアウトは固定されているか、ライトは名前が付けられているか、演技は控えめか?そうでない場合は、エージェントが繰り返さないよう、何が間違っているか正確に伝えてください。エージェントとの対話(ドキュメント)では、保持すべきルールの保存方法を紹介しています。
リアルな動画を作成するAIモデルとそのコスト
In 'twixt Vowsでは、各モデルに1つの役割を割り当てました:アイデア、レイアウト、最終静止画、そして動画。
| モデル | 映画での役割 | 映画のために制作 | 生成あたりのクレジット(中央値) | 生成あたりの時間(中央値) |
|---|---|---|---|---|
| Midjourney | アイデアと最初のルック | 84枚の画像 | 合計210(21回の生成) | 約20秒 |
| GPT Image 2 | ホワイトモデルのレイアウト | 158枚の画像 | 新規約11、編集約18 | 約1.5〜2分 |
| Nano Banana Pro | 最終フォトリアル静止画 | 903枚の画像 | 約30 | 約30〜40秒 |
| Seedance 2.0 | 動画テイク | 157クリップ | リファレンス使用で約540 | 約5分 |
| Seedance 2.5 | 動画テイク | 190クリップ | リファレンス使用で約360 | 約5分 |
「映画のために制作」はFlickの公開された映画の内訳に基づいており、破棄されたテイクも含まれます。クレジットと時間は、このプロジェクトでの成功した生成あたりの中央値です。ただしMidjourneyのクレジットは合計値です(Flickデータ、2026年7月24日〜10月14日)。
- 静止画は安価、動画はそうではない。映画の1,549回の成功した生成のうち72%が画像でしたが、動画が223,959クレジットの86%を消費しました(Flickデータ、2026年7月24日〜10月14日)。アニメーション化する前にフレームを確定させましょう。
- 完成した1分あたり約14,000クレジット:16分の映画で223,959クレジット(同データ)。
- 映画の上映時間の5.6倍の動画:960秒の映画に対して5,381秒の生成動画(Flickの公開内訳)、つまりほとんどは最終的にカットされました。
Flickで最初のリアルなAI動画を作成する
サインアップして、キャンバスを開き、1つのショットで5つの修正を試してみてください。
すべてのアカウントは、サインアップ時に100クレジット、毎週月曜日にさらに100クレジットを無料で受け取れます。
無料のFlickアカウントを作成 →
さらに詳しく
- In 'twixt Vowsのメイキング Jaime Yao本人による完全な講演。
- Nano Banana Proガイド 3Dブロックアウトとのマッチングを含む、静止画モデルの得意分野。
- AIカメラムーブメント 実際のプロンプトを使った12のカメラワークと、3D Stageでムーブメントを描くタイミング。
- AI映画の作り方 Flickで制作された9本の映画のデータを用いた、ビートから編集までの全プロセス。
- AIで戦闘シーンを振り付ける方法 In 'twixt Vowsのタイミング付き、番号付き戦闘ショット。
- Omni Reference(ドキュメント) Flickのリファレンス-to-動画モードが各リファレンスをどのように使用するか:開始フレーム、キャラクター、カメラムーブメント、スピーチ。
著者について
Bilguun BayarkhuuはFlickのグロースエンジニアです。このガイドは、Jaime YaoによるIn 'twixt Vowsの公開ワークフロー、FlickのYouTubeチャンネルでのJaimeのチュートリアル、およびFlickの映画に関する生成データに基づいて構築されています。
よくある質問
最もリアルなAI動画はどれですか?
単一の勝者はなく、モデルよりも演出の方が重要です。16分のフォトリアルな映画「In 'twixt Vows」では、Jaime Yaoが最終的な静止画をNano Banana Proで、動画をSeedance 2.5と2.0で制作しました。撮影されたように見えた理由は、入力にありました。すでに撮影されたように見える静止画と、光、素材、カメラ、演技を物理的なものとして記述したプロンプトです。
リアルなAI動画を作るには?
すべてのセットを実在の場所に基づいて作成します。各静止画を固定されたレイアウトから構築し、名前付きの光、素材の劣化、焦点となる被写体を配置し、最後にグレインを追加します。カメラを持つ人としてカメラを記述し、演技を小さなタイミングの行動として演出し、アクションを時間枠内での接触、力、反応として記述します。
AIはどうやってこんなにリアルな動画を生成するのですか?
プロンプトの穴を少なくすると、リアルに見えます。動画モデルはプロンプトのすべての穴を最も平均的な推測で埋めます。その平均的な見た目がAIらしさとして認識されます。すでに撮影されたように見えるフレームから始め、光、素材、カメラ、演技を物理的な動作として記述します。
AI画像をリアルに見せるには?
ショットを白い平面モデルとしてレイアウトし、次にNano Banana Proのようなフォトリアルなモデルに、そのレイアウトを「100%変更しない」まま素材と光のみを変更させます。光源と暗いままの部分を名前で指定し、各表面が経験したことを述べ、フィルムグレイン、センサーノイズ、軽いレンズのソフトネスを1行で締めくくります。
AI動画に適した良いプロンプトは?
画面上で確認できることを記述するプロンプトです。「手持ち、感情的」の代わりに、「In 'twixt Vows」では「カメラオペレーターが彼女に向き合って後ろ向きに歩く」や「唇は静かな会話の分だけ開く」と記述しています。リファレンスがすでに示していることを固定し、変化するもののみを記述し、後で音楽を付ける場合は「背景音楽なし」を追加します。
人々はどうやってリアルなAI動画を作っているのですか?
最初にフォトリアルな静止画を作成してからアニメーション化し、各作業に1つのモデルを使用しています。Flickで制作された16分の映画「In 'twixt Vows」では、Jaime YaoがMidjourneyをアイデア出しに、GPT Image 2をレイアウトに、Nano Banana Proを最終的な静止画に、Seedance 2.0と2.5を動画に使用しました。