Sincronización labial con Kling AI: Cómo hacer hablar a un personaje
Para la sincronización labial con Kling AI, dale a Kling Avatar una imagen fija de tu personaje y una línea grabada, y moverá la boca y el rostro al sonido de ese audio.
La sincronización labial con Kling AI parece fácil hasta que la línea importa: un modelo de video al que se le pide pronunciar una línea citada puede cambiar las palabras, acelerar las pausas o dar al personaje una nueva voz en cada toma. En Flick, el modelo de sincronización labial de Kling es Kling Avatar, ejecutado como Character Dialogue, y toma la voz de una grabación que elijas en lugar de inventar una. Seguimos una escena de diálogo de The Herder, un cortometraje en miniatura de 4:27 por Jaime Yao, a través de las 11 tomas de video y la única línea de voz generada para ella en su lienzo público. Esta guía muestra los cuatro pasos desde el fotograma fijo hasta la toma hablada, con los prompts exactos detrás de cada uno.
La sincronización labial con Kling AI anima la boca y el rostro de un personaje para coincidir con el habla, ya sea de audio que proporciones con Kling Avatar o de una línea citada que un modelo de video de Kling vocaliza por sí mismo.
Las dos formas de hacer hablar a un personaje con Kling en Flick, según con qué empiezas
Empiezas con
Usar en Flick
Qué decide la voz
Una imagen fija y una línea grabada
Diálogo de Personaje, con Kling AI Avatar v2 o Kling AI Avatar v2 Pro
Tu audio, palabra por palabra y pausa por pausa
Una imagen fija y una línea escrita
Imagen a Video, con un modelo Kling que genera sonido, como Kling 3.0 Pro
El modelo, que escribe la voz y el movimiento juntos
Diálogo de Personaje es la herramienta de sincronización labial: mantiene la voz, las palabras y el timing del audio que adjuntas.
Un modelo de video Kling también mueve el cuerpo y la cámara, por eso The Herder probó ambos para un saludo.
¿Cómo sincronizas los labios de un personaje con Kling AI, paso a paso?
Elige la imagen fija que mantiene la pose para toda la línea, graba la línea, luego adjunta ambas a Diálogo de Personaje y elige un modelo Kling Avatar.
Paso 1
Elige el fotograma
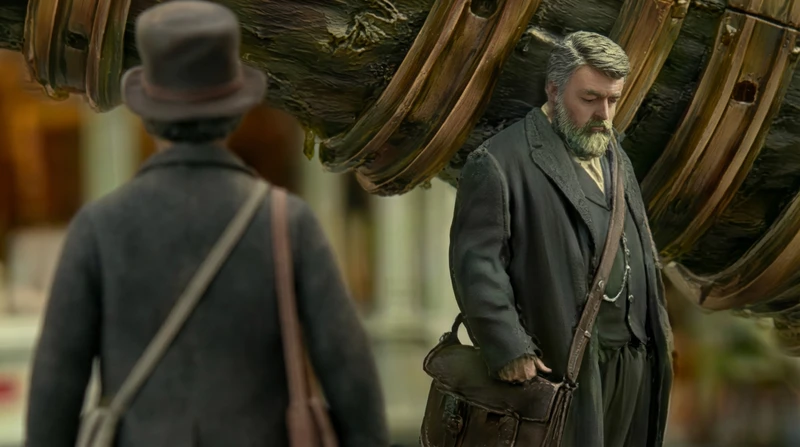
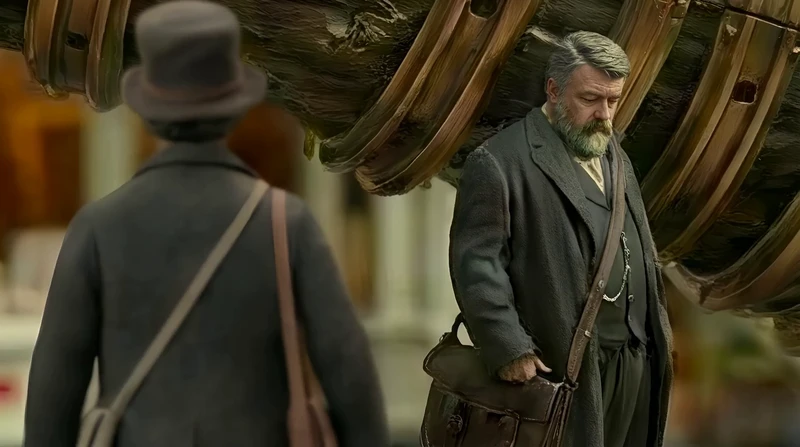
Elige una imagen fija donde el rostro que habla sea grande, nítido y en la pose que quieres para toda la línea, porque Kling Avatar anima esa única imagen y no mueve al personaje a otro lugar.
El fotograma es una edición de Nano Banana Pro, escrita en chino, que desenfoca al hombre en primer plano y le da al hombre barbudo un aspecto de estudio en miniatura.
El mismo fotograma es el fotograma inicial de 8 de las 11 tomas de video de esta escena, por lo que cada intento comenzó desde una sola imagen.
La cabeza del hombre barbudo está baja aquí, y la sincronización labial final la mantiene baja.
The Herder, dirigida por Jaime Yao · Nano Banana Pro
Paso 2
Escribe la línea exacta
Escribe la línea palabra por palabra, con su puntuación y pausas, antes de generar cualquier audio, para que la toma de voz y el prompt de video trabajen ambos desde el mismo guion.
Jaime primero pidió a Kling 3.0 Pro que dijera la línea dentro de una acción más larga: mirar hacia arriba, saludar, estrechar la mano, seguir caminando.
5 tomas de Kling 3.0 Pro y 1 toma de Seedance 1.5 Pro de esta escena citan la línea exactamente, con "Speak exactly the quoted lines only."
Una toma como esta es sincronización labial creada por el modelo de video, por lo que su voz es la que el modelo elige.
Primer fotograma00:10
The Herder, dirigida por Jaime Yao · Kling 3.0 Pro · Imagen a video
Same miniature diorama street and shallow macro depth of field, soft daylight. The fallen diagonal tree trunk wrapped in thin brass rings remains fixed in the background.

Man A (heavyset, gray beard, dark long coat, leather satchel) starts with head lowered and silent.
Man B (slimmer, worn dark coat, round top hat, cross-body bags, wooden walking stick) is approaching from behind the camera, mostly back-facing. From the very first frame, Man B is already walking forward at a steady pace (continuous walking, no pause, no hesitation), entering the scene from behind the camera.

Man A first lifts his head, looks directly toward Man B, and only then begins speaking. Man A speaks clearly in English with visible lip-sync, saying:

“Ah, Tuner Kagran. At last.
I trust your journey was… agreeable.
Ours, regrettably, has not been.”

Action sequence (one continuous shot):

Man A’s mouth stays closed until after he has fully raised his head and made eye contact toward Man B. While speaking the lines above, Man A keeps his gaze up toward Man B and speaks with clear mouth movement and slight pauses matching the punctuation.

Man B keeps walking forward during the speech and arrives near Man A.

After the final line, Man A steps forward and extends his left hand.

They shake hands once using their left hands only (firm but brief). Man B keeps the walking stick in his right hand during the handshake.

Immediately after the handshake, Man A turns his body toward the fallen trunk and gestures forward, then begins walking to lead Man B toward the trunk.

Man B follows alongside, holding the walking stick, as they approach the trunk together.

Keep the environment unchanged. No camera movement. No new characters. This scene has a very handheld feel. Do not add any extra words. Speak exactly the quoted lines only.
Significado:Dos hombres se encuentran en una calle de diorama en miniatura, hablan, se dan la mano izquierda y caminan juntos hacia un tronco caído.
Paso 3
Dale voz a la línea
Genera la línea en Texto a Voz con Eleven v3, o grábala tú mismo, y conserva la toma cuyo ritmo se ajuste al personaje, ya que Kling Avatar copia exactamente el timing del audio.
La línea de The Herder dura 8.75 segundos, con una pausa sostenida antes de "agreeable" y un cierre más lento.
Texto a Voz con Eleven v3 está disponible en el plan Free, a 8 créditos por generación.
Diálogo de Personaje también acepta tu propia grabación como archivo mp3, wav, m4a, ogg o aac.
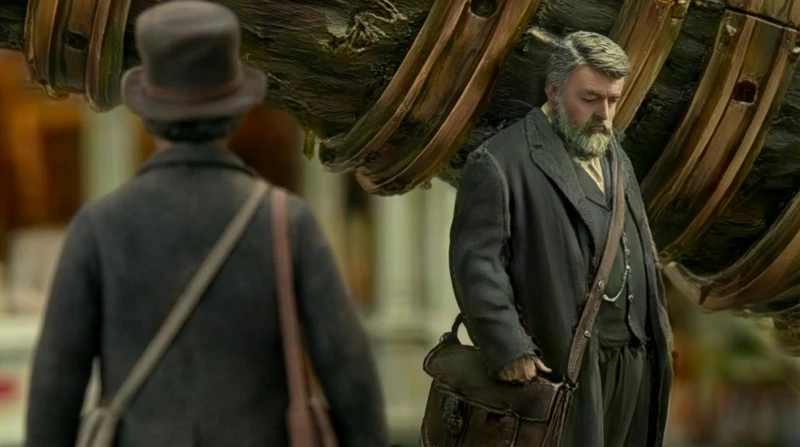
Adjunta la imagen fija como Imagen de Personaje y la línea como Audio, elige Kling AI Avatar v2 o Kling AI Avatar v2 Pro, y añade un Prompt cuando quieras dirigir la expresión.
Jaime ejecutó Kling AI Avatar v2 Pro con el Prompt vacío, por lo que el rostro sigue únicamente la voz.
El clip dura 8,8 segundos, la duración de la línea, porque Character Dialogue crea un clip tan largo como su audio.
Character Dialogue funciona en el plan Standard ($20 al mes) y se factura por segundo de audio.
The Herder, dirigida por Jaime Yao · Kling AI Avatar v2 Pro
Más detalle: cómo leemos la escena
Cada prompt en esta página está copiado palabra por palabra del lienzo público de The Herder, leído el 27-10-2026. Los recuentos corresponden a medios generados en ese lienzo, incluidas las tomas archivadas. El lienzo no registra desde qué imagen se creó un clip de Character Dialogue; el fotograma en el paso 1 coincide exactamente con el encuadre del clip, y es el fotograma inicial de 8 de las tomas de video. Las palabras de la línea de voz se leen del audio. El saludo no aparece en el corte de 4:27 de la película mostrado en Flick TV.
¿Qué se necesitó para hacer una línea sincronizada?
Un saludo requirió 11 tomas de video de dos modelos de video y una línea de voz, antes de que un único clip de Character Dialogue lo pronunciara con una voz que se fijó de antemano.
Medios generados para el saludo bajo el tronco con anillos de bronce en el lienzo público de The Herder, leído el 27-10-2026
Qué
Cantidad
Hecho con
Tomas de video de la escena
11
Kling 3.0 Pro 10, Seedance 1.5 Pro 1
Tomas que citan la línea exactamente
6
Kling 3.0 Pro 5, Seedance 1.5 Pro 1
Líneas de voz
1
Eleven v3
Clips sincronizados labialmente
1
Kling AI Avatar v2 Pro
¿Qué hace que la sincronización labial de Kling se vea bien?
Fija la voz y las palabras antes de la imagen, elige un fotograma que se adapte a toda la línea y mantén la toma de sincronización labial solo para el diálogo.
1. Elige la pose en el fotograma
Selecciona el fotograma que muestre cómo debe verse el personaje mientras habla, porque Kling Avatar anima el rostro donde está en el fotograma, y el hombre de The Herder pronuncia toda su línea con la cabeza agachada.
2. Crea el audio primero
Define la grabación de voz antes del video, ya que el audio establece la duración del clip y cada forma de la boca, y una nueva grabación significa una nueva sincronización labial.
3. Fija las palabras en un prompt de video
Cuando un modelo de video Kling pronuncie la línea en su lugar, indícale que diga las palabras citadas y nada más, para que los labios no sigan una línea reformulada.
Do not add any extra words. Speak exactly the quoted lines only.
Significado:Un hombre habla exactamente las líneas citadas sin agregar palabras adicionales en la escena con aspecto de diorama en miniatura.
4. Mantén la boca cerrada hasta el momento adecuado
Indica cuándo comienza el diálogo además de lo que se dice, para que un personaje no empiece a hablar antes de mirar a la persona a quien va dirigida la línea.
Man A’s mouth stays closed until after he has fully raised his head and made eye contact toward Man B.
Significado:Un hombre habla con esfuerzo visible, su respiración y tensión facial muestran que hablar requiere trabajo y dificultad física.
6. Separa el diálogo y la acción
Dale a la línea su propia toma de sincronización labial y deja los apretones de manos y las caminatas para un clip de video, porque las tomas de The Herder que combinaban ambas cosas en una sola debían lograr que la voz y el movimiento salieran bien al mismo tiempo.
Preguntas sobre la sincronización labial con Kling AI
¿Qué es la sincronización labial con Kling AI?
La sincronización labial de Kling AI es la forma de Kuaishou de hacer que la boca y el rostro de un personaje se muevan en sincronía con el diálogo. En Flick funciona como Character Dialogue, con los modelos Kling Avatar, que animan una imagen fija con una línea de audio que adjuntas.
¿Cómo sincronizo los labios de una imagen con Kling AI?
Abre Diálogo de Personaje en Flick, adjunta la imagen como Imagen de Personaje y una línea hablada como Audio, y elige Kling AI Avatar v2 o Kling AI Avatar v2 Pro. El resultado es un video de la misma duración que el audio, con el rostro hablándolo.
¿La sincronización de labios de Kling AI es gratis?
Diálogo de Personaje con los modelos Kling Avatar requiere el plan Standard de Flick, a $20 al mes, y se factura por segundo de audio. Crear la línea con Texto a Voz y Eleven v3 está disponible en el plan Free.
¿Cuál es la diferencia entre Kling Avatar v2 y v2 Pro?
Ambos animan una imagen fija con una línea de audio y mantienen la apariencia del personaje; Kling AI Avatar v2 Pro es la versión premium con más detalle y cuesta más por segundo de audio. The Herder utilizó el modelo Pro para su saludo.
¿Puede Kling sincronizar los labios con mi propia voz?
Sí. Graba la línea y súbela como un archivo mp3, wav, m4a, ogg o aac, luego adjúntala como el Audio en Diálogo de Personaje. El personaje habla con tus palabras exactas y tu ritmo.
¿Debería usar Kling Avatar o Kling 3.0 para diálogos?
Usa Kling Avatar en Diálogo de Personaje cuando la voz y las palabras deben ser exactas, y un modelo de video Kling como Kling 3.0 Pro cuando el personaje también tiene que caminar, gesticular o moverse con la cámara mientras habla. Muchas escenas usan ambos: un clip de video para la acción, un clip de sincronización de labios para la línea.
¿Puede Kling AI sincronizar los labios de un video en lugar de una imagen?
Diálogo de Personaje en Flick parte de una imagen fija, no de un video. Para hacer que una toma en movimiento hable, toma un fotograma de ella como imagen fija, o escribe la línea en un prompt de Imagen a Video para un modelo Kling que genere sonido.
Cada toma en esta página proviene del lienzo público The Herder y está acreditada a su cineasta, Jaime Yao, excepto el Prompt citado de Ulysses, también de Jaime Yao.
Dale a tu personaje una línea para decir
Graba la línea, elige el fotograma y deja que Kling mueva los labios, con cada toma en un solo lienzo.

 00:09