Kling AI 口型同步:如何让角色说话

对于 Kling AI 口型同步,只需给 Kling Avatar 一张角色静态图和一段录制的台词,它就会让嘴部和面部随音频同步移动。

淡桃色背景上的一幅木制牵线木偶墨画,嘴巴张开说话中

Kling AI 口型同步看似简单,但当台词很重要时就不那么容易了:被要求说出引用台词的视频模型可能会改变词句、匆忙略过停顿或在每次生成时给角色换一个新声音。在 Flick 中,Kling 的口型同步模型是 Kling Avatar,以角色对话形式运行,它会使用你选择的录音中的声音,而不是自己发明一个。我们跟踪了 Jaime Yao 制作的 4:27 微型短片《The Herder》中的一个对话场景,在其公开画布上经历了 11 次视频生成和 1 次为其生成的语音台词。本指南展示了从静态帧到说话镜头的四个步骤,以及每个步骤背后的确切提示词。

什么是 Kling AI 口型同步?

Kling AI 口型同步可以让角色的嘴部和面部动画与语音匹配,语音可以是你使用 Kling Avatar 提供的音频,也可以是 Kling 视频模型自己配音的引用台词。
在 Flick 中使用 Kling 让角色说话的两种方法,取决于你的起始素材
你的起始素材是在 Flick 中使用什么决定声音
一张静止图像和一段录制的台词角色对话,使用 Kling AI Avatar v2 或 Kling AI Avatar v2 Pro你的音频,逐字逐句,连停顿都保持一致
一张静止图像和一段输入的台词图像转视频,使用可生成声音的 Kling 模型,例如 Kling 3.0 Pro模型会同时生成声音和动作
  • 角色对话是口型同步工具:它保留你附加的音频中的声音、文字和时间节奏。
  • Kling 视频模型还会移动身体和镜头,这就是为什么《牧羊人》为一句问候尝试了两种方式。

如何使用 Kling AI 为角色进行口型同步,分步骤说明?

选择一张能为整句台词保持姿势的静止图像,为台词配音,然后将两者附加到角色对话并选择一个 Kling Avatar 模型。
  1. 第 1 步

    选择画面

    选择一张说话的脸部清晰、锐利且处于你希望整句台词保持的姿势的静止图像,因为 Kling Avatar 只会对这一张图像进行动画处理,不会将角色移动到其他位置。

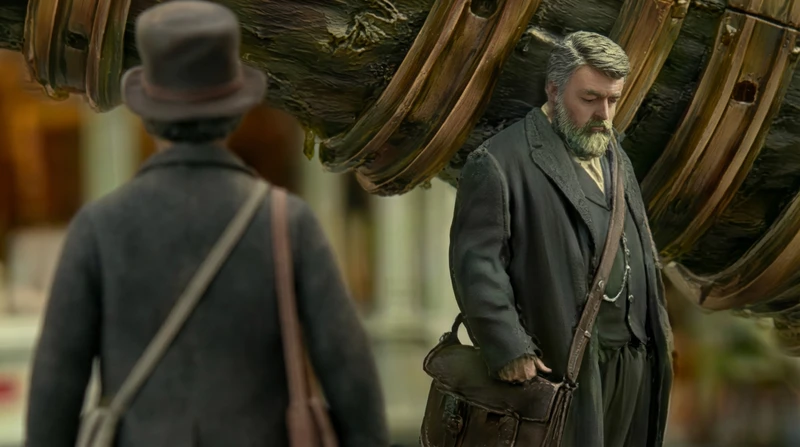
    • 这个画面是用 Nano Banana Pro 编辑的,以中文编写,模糊了前景中的男人,并为留胡子的男人打造了微型工作室的效果。
    • 同一画面是这个场景 11 个视频镜头中 8 个的起始画面,因此每次尝试都从同一张图片开始。
    • 留胡子的男人的头在这里是低着的,完成的口型同步保持了这个姿势。
    A grey-bearded man with his head lowered stands under a brass-ringed tree trunk while a man in a top hat waits in the blurred foreground
    Jaime Yao 执导的《The Herder》 · Nano Banana Pro
  2. 第 2 步

    撰写准确的台词

    在生成任何音频之前,逐字逐句地写下台词,包括标点符号和停顿,这样语音录制和视频提示词都可以基于同一脚本工作。

    • Jaime 首先要求 Kling 3.0 Pro 在一个较长的动作中说出台词:抬头、打招呼、握手、继续前行。
    • 这个场景的 5 个 Kling 3.0 Pro 版本和 1 个 Seedance 1.5 Pro 版本准确引用了台词,并使用了"仅准确说出引用的台词"的指令。
    • 像这样的版本是由视频模型制作的口型同步,因此其语音是模型选择的任何声音。
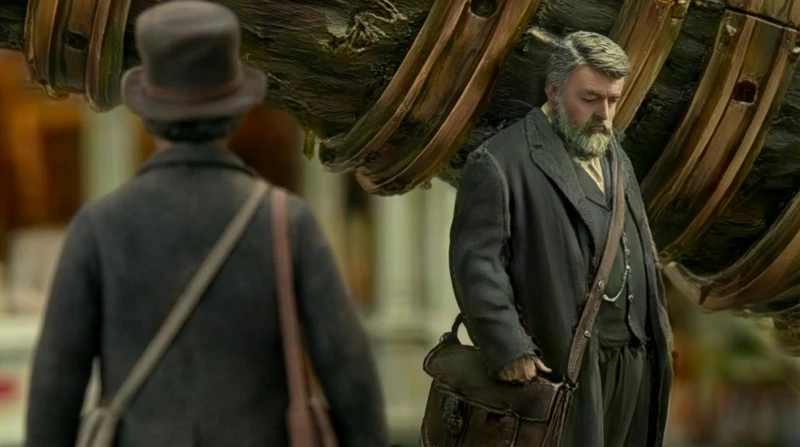
    The bearded man raises his head and speaks to the man in the top hat, then offers his hand, in a Kling 3.0 Pro take
    第一帧:The bearded man raises his head and speaks to the man in the top hat, then offers his hand, in a Kling 3.0 Pro take
    第一帧
    00:10
    Jaime Yao 执导的《The Herder》 · Kling 3.0 Pro · 图像转视频
    Same miniature diorama street and shallow macro depth of field, soft daylight. The fallen diagonal tree trunk wrapped in thin brass rings remains fixed in the background.
    
    Man A (heavyset, gray beard, dark long coat, leather satchel) starts with head lowered and silent.
    Man B (slimmer, worn dark coat, round top hat, cross-body bags, wooden walking stick) is approaching from behind the camera, mostly back-facing. From the very first frame, Man B is already walking forward at a steady pace (continuous walking, no pause, no hesitation), entering the scene from behind the camera.
    
    Man A first lifts his head, looks directly toward Man B, and only then begins speaking. Man A speaks clearly in English with visible lip-sync, saying:
    
    “Ah, Tuner Kagran. At last.
    I trust your journey was… agreeable.
    Ours, regrettably, has not been.”
    
    Action sequence (one continuous shot):
    
    Man A’s mouth stays closed until after he has fully raised his head and made eye contact toward Man B. While speaking the lines above, Man A keeps his gaze up toward Man B and speaks with clear mouth movement and slight pauses matching the punctuation.
    
    Man B keeps walking forward during the speech and arrives near Man A.
    
    After the final line, Man A steps forward and extends his left hand.
    
    They shake hands once using their left hands only (firm but brief). Man B keeps the walking stick in his right hand during the handshake.
    
    Immediately after the handshake, Man A turns his body toward the fallen trunk and gestures forward, then begins walking to lead Man B toward the trunk.
    
    Man B follows alongside, holding the walking stick, as they approach the trunk together.
    
    Keep the environment unchanged. No camera movement. No new characters. This scene has a very handheld feel. Do not add any extra words. Speak exactly the quoted lines only.
    含义:微缩场景街道,两个穿大衣的男人在倒下的树干前相遇握手并交谈后一起走向树干。
  3. 第 3 步

    配音台词

    使用 Eleven v3 的文本转语音生成台词,或者自己录制,并保留节奏符合角色的版本,因为 Kling Avatar 会精确复制音频的时长。

    • The Herder 的台词时长 8.75 秒,在"agreeable"之前有一个停顿,结尾节奏较慢。
    • Eleven v3 的文本转语音在 Free 套餐中提供,每次生成消耗 8 积分。
    • 角色对话还支持上传您自己录制的 mp3、wav、m4a、ogg 或 aac 格式音频文件。
    00:09
    Jaime Yao 执导的《The Herder》 · Eleven v3
  4. 第 4 步

    运行角色对话

    将静态图像作为角色图像附加,将台词作为音频附加,选择 Kling AI Avatar v2 或 Kling AI Avatar v2 Pro,并在需要控制表情时添加提示词。

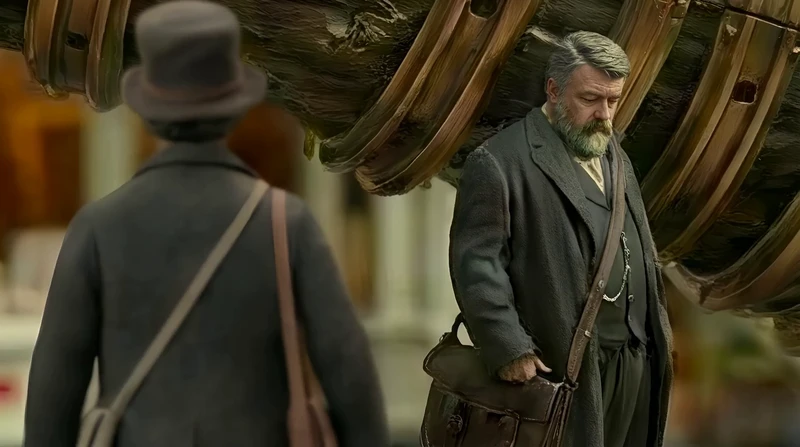
    • Jaime 使用 Kling AI Avatar v2 Pro 时将提示词留空,因此面部仅跟随语音。
    • 片段时长 8.8 秒,即台词的长度,因为角色对话会生成与音频等长的片段。
    • 角色对话在 Standard 套餐(每月 $20)上运行,按音频秒数计费。

    打开 The Herder 工作流

    The grey-bearded man speaks the greeting with his head lowered under the brass-ringed trunk, lip synced by Kling Avatar v2 Pro00:09
    由 Jaime Yao 执导的《The Herder》 · Kling AI Avatar v2 Pro
更多细节:我们如何解读场景

此页面上的每个提示词都逐字复制自公开的 The Herder 画布,读取时间为 2026-10-27。计数包括该画布上生成的媒体,含已归档的版本。画布未记录角色对话片段基于哪张图像制作;步骤 1 中的帧与片段的构图完全匹配,且是 8 个视频版本的起始帧。语音台词的文字从音频中读取。这段问候语不在 Flick TV 上展示的 4:27 剪辑版影片中。

制作一段口型同步的台词需要什么?

一句问候语需要两个视频模型生成的 11 个视频版本和一条语音台词,才最终由一个角色对话片段用预先固定的声音说出。
在公开的 The Herder 画布上为铜环树干下的问候语生成的媒体,读取时间为 2026-10-27
内容数量制作工具
场景的视频版本11Kling 3.0 Pro 10 个,Seedance 1.5 Pro 1 个
完全引用台词的版本6Kling 3.0 Pro 5 个,Seedance 1.5 Pro 1 个
语音台词1Eleven v3
口型同步片段1Kling AI Avatar v2 Pro

是什么让 Kling 口型同步看起来自然?

先确定语音和台词再处理画面,选择适合整句台词的静止画面,并将口型同步镜头限制在说话部分。
  1. 1. 在静止画面中选择姿势

    选择角色说话时应有外观的帧,因为 Kling Avatar 会在静止画面中对面部进行动画处理,而牧羊人的男子在整句台词中都低着头说话。

  2. 2. 先制作音频

    在视频之前确定语音录制,因为音频决定了片段的长度和每个口型,而新的录制意味着新的口型同步。

  3. 3. 在视频提示词中锁定台词

    当使用 Kling 视频模型来配音时,告诉它只说引用的台词,不说其他内容,这样嘴唇就不会跟随改写后的台词。

    Do not add any extra words. Speak exactly the quoted lines only.
    Jaime Yao 执导的《The Herder》
    含义:仅说引用的台词,不添加任何额外的词语。
  4. 4. 保持闭口直到合适的表情

    说明语音何时开始以及说了什么,这样角色就不会在面向说话对象之前就开始说话。

    Man A’s mouth stays closed until after he has fully raised his head and made eye contact toward Man B.
    Jaime Yao 执导的《The Herder》
    含义:男人A抬起头与男人B对视后才开口说话。
  5. 5. 在提示词中引导面部表情

    使用角色对话的可选提示词来控制表情和力度,而不是台词,因为台词已经来自音频。

    His breathing and facial tension should make the line feel effortful, almost like speaking takes work.
    Jaime Yao 执导的《Ulysses》
    含义:他的呼吸和面部紧张使台词显得费力,说话似乎需要努力。
  6. 6. 将说话和动作分开

    为台词单独设置口型同步镜头,将握手和走路留给视频片段,因为牧羊人将两者合并到一个镜头中的拍摄需要同时确保语音和动作的准确性。

关于 Kling AI 口型同步的问题

什么是 Kling AI 口型同步?

Kling AI 口型同步是快手让角色的嘴部和面部随语音同步移动的方式。在 Flick 中,它以角色对话的形式运行,使用 Kling Avatar 模型,可以将单个静止图像动画化为您附加的音频台词。

如何使用 Kling AI 为图片添加口型同步?

在 Flick 中打开角色对话功能,将图片作为角色图像上传,将语音作为音频上传,然后选择 Kling AI Avatar v2 或 Kling AI Avatar v2 Pro。生成的视频长度与音频相同,面部会说出音频内容。

Kling AI 口型同步免费吗?

使用 Kling Avatar 模型的角色对话功能需要 Flick 的 Standard 套餐,每月 20 美元,按音频秒数计费。使用文本转语音和 Eleven v3 制作台词属于 Free 套餐。

Kling Avatar v2 和 v2 Pro 有什么区别?

两者都能将静态图像根据音频进行动画处理并保持角色外观;Kling AI Avatar v2 Pro 是高级版本,细节更丰富,但每秒音频的费用更高。The Herder 使用 Pro 模型制作了其问候场景。

Kling 能同步我自己的声音吗?

可以。录制台词并上传为 mp3、wav、m4a、ogg 或 aac 文件,然后在角色对话中将其作为音频上传。角色会说出你的确切词句和时机。

对话应该使用 Kling Avatar 还是 Kling 3.0?

当声音和词句必须精确时,在角色对话中使用 Kling Avatar;当角色还需要边说话边行走、做手势或跟随镜头移动时,使用 Kling 3.0 Pro 等 Kling 视频模型。许多场景同时使用两者:用视频片段表现动作,用口型同步片段表现台词。

Kling AI 能为视频而不是图片添加口型同步吗?

Flick 中的角色对话功能从静态图像开始,而不是视频。要让运动镜头说话,可以从中提取一帧作为静态图像,或将台词写入图像转视频提示词中,使用能生成声音的 Kling 模型。

更多关于在 Flick 中让角色说话的内容

本指南中的影片

本页面上的每个镜头都来自公开的 The Herder 画布,版权归其制作者 Jaime Yao 所有,但引用的提示词来自 Ulysses,同样由 Jaime Yao 创作。

为你的角色添加台词

配音台词,选择画面,让 Kling 来驱动口型,所有镜次都在一个画布上完成。

在 Flick 中让角色说话

免费试用,无需信用卡。

让 AI 解读本页:ChatGPTPerplexityClaude