Kling AI 對嘴同步:如何讓角色說話

對於 Kling AI 對嘴同步,給 Kling Avatar 一張角色靜態圖和一段錄音台詞,它會讓嘴巴和臉部隨著音訊的聲音移動。

淡桃色背景上的木製牽線木偶的墨水繪畫,嘴巴張開說話中

Kling AI 對嘴同步看起來很簡單,直到台詞變得重要:要求說出引用台詞的視訊模型可能會改變文字、加快停頓或在每次拍攝中給角色一個新的聲音。在 Flick 中,Kling 的對嘴同步模型是 Kling Avatar,以角色對話執行,它會從你選擇的錄音中擷取聲音,而不是創造一個。我們追蹤了 The Herder(Jaime Yao 的 4:27 迷你短片)中的一個對話場景,經過 11 個視訊拍攝和為其生成的一條語音台詞,這些都在其公開畫布上。本指南展示了從靜態畫面到說話鏡頭的四個步驟,以及每個步驟背後的確切提示詞。

什麼是 Kling AI 對嘴同步?

Kling AI 對嘴同步讓角色的嘴巴和臉部隨著語音動畫化以配對,可以使用你透過 Kling Avatar 提供的音訊,或使用 Kling 視訊模型自己配音的引用台詞。
在 Flick 中使用 Kling 讓角色說話的兩種方法,依你的起始素材而定
你從以下開始在 Flick 中使用決定聲音的因素
一張靜態圖和一段錄音角色對話,搭配 Kling AI Avatar v2 或 Kling AI Avatar v2 Pro你的音訊,逐字逐句、停頓對停頓
一張靜態圖和一段文字台詞圖片轉影片,搭配具備聲音功能的 Kling 模型,例如 Kling 3.0 Pro模型會同時生成聲音和動作
  • 角色對話是唇形同步工具:它會保留你附加音訊的聲音、文字和時間點。
  • Kling 影片模型也會移動身體和鏡頭,這就是為什麼《牧羊人》為同一段問候嘗試了兩種方式。

如何使用 Kling AI 為角色進行對嘴同步,逐步說明?

挑選一張能在整段台詞中保持姿勢的靜態圖,為台詞配音,然後將兩者附加到角色對話並選擇 Kling Avatar 模型。
  1. 第 1 步

    挑選畫面

    選擇一張說話臉部清晰、放大且呈現你希望整段台詞保持姿勢的靜態圖,因為 Kling Avatar 會為該單一圖片製作動畫,不會將角色移動到其他地方。

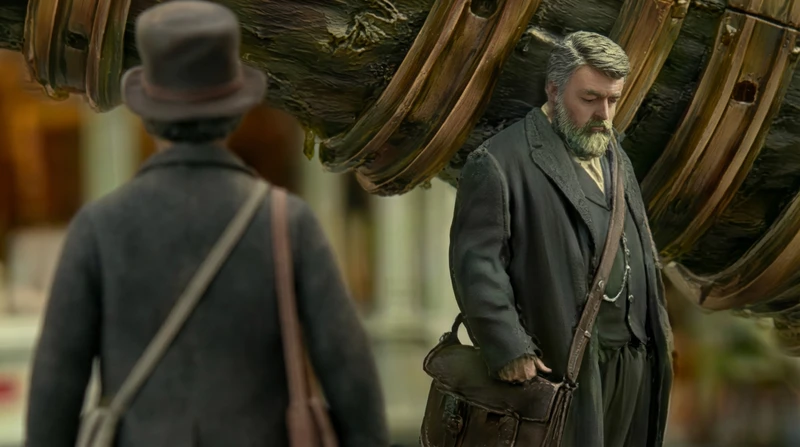
    • 這個畫面是 Nano Banana Pro 的編輯成果,以中文撰寫提示詞,模糊了前景中的男子,並為鬍鬚男子營造了迷你攝影棚的效果。
    • 同一個畫面是這個場景 11 個影片版本中 8 個的起始畫面,因此每次嘗試都從同一張圖片開始。
    • 鬍鬚男子的頭在這裡是低下的,完成的唇形同步也保持了低頭姿勢。
    A grey-bearded man with his head lowered stands under a brass-ringed tree trunk while a man in a top hat waits in the blurred foreground
    Jaime Yao 執導的《The Herder》 · Nano Banana Pro
  2. 第 2 步

    撰寫確切的台詞

    在製作任何音訊之前,先逐字撰寫台詞,包含標點符號和停頓,這樣配音和影片提示詞都能使用相同的腳本。

    • Jaime 首先要求 Kling 3.0 Pro 在較長的動作中說出台詞:抬頭、打招呼、握手、繼續前行。
    • 這個場景的 5 個 Kling 3.0 Pro 成果和 1 個 Seedance 1.5 Pro 成果完全引用台詞,並加上「僅說出引用的台詞」。
    • 像這樣的成果是由影片模型製作的唇形同步,因此聲音是由模型選擇的。
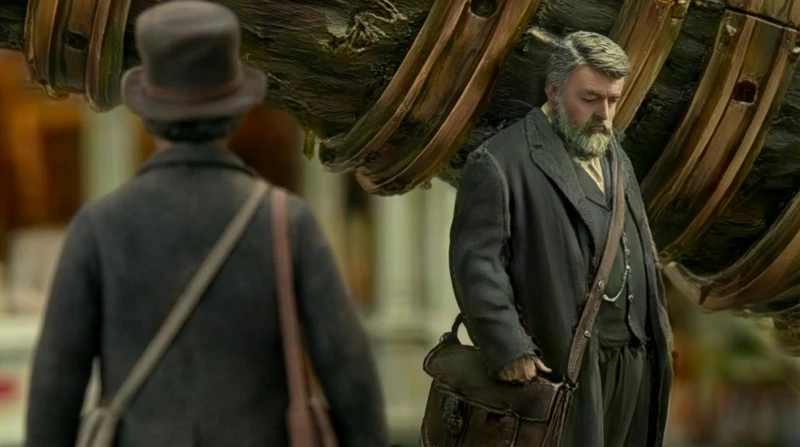
    The bearded man raises his head and speaks to the man in the top hat, then offers his hand, in a Kling 3.0 Pro take
    第一幀:The bearded man raises his head and speaks to the man in the top hat, then offers his hand, in a Kling 3.0 Pro take
    第一幀
    00:10
    Jaime Yao 執導的《The Herder》 · Kling 3.0 Pro · 圖像轉影片
    Same miniature diorama street and shallow macro depth of field, soft daylight. The fallen diagonal tree trunk wrapped in thin brass rings remains fixed in the background.
    
    Man A (heavyset, gray beard, dark long coat, leather satchel) starts with head lowered and silent.
    Man B (slimmer, worn dark coat, round top hat, cross-body bags, wooden walking stick) is approaching from behind the camera, mostly back-facing. From the very first frame, Man B is already walking forward at a steady pace (continuous walking, no pause, no hesitation), entering the scene from behind the camera.
    
    Man A first lifts his head, looks directly toward Man B, and only then begins speaking. Man A speaks clearly in English with visible lip-sync, saying:
    
    “Ah, Tuner Kagran. At last.
    I trust your journey was… agreeable.
    Ours, regrettably, has not been.”
    
    Action sequence (one continuous shot):
    
    Man A’s mouth stays closed until after he has fully raised his head and made eye contact toward Man B. While speaking the lines above, Man A keeps his gaze up toward Man B and speaks with clear mouth movement and slight pauses matching the punctuation.
    
    Man B keeps walking forward during the speech and arrives near Man A.
    
    After the final line, Man A steps forward and extends his left hand.
    
    They shake hands once using their left hands only (firm but brief). Man B keeps the walking stick in his right hand during the handshake.
    
    Immediately after the handshake, Man A turns his body toward the fallen trunk and gestures forward, then begins walking to lead Man B toward the trunk.
    
    Man B follows alongside, holding the walking stick, as they approach the trunk together.
    
    Keep the environment unchanged. No camera movement. No new characters. This scene has a very handheld feel. Do not add any extra words. Speak exactly the quoted lines only.
    含義:微縮街景中兩名男子相遇握手交談,其中一人引領另一人走向倒下的樹幹。
  3. 第 3 步

    為台詞配音

    使用 Eleven v3 的文字轉語音生成台詞,或自行錄製,並保留符合角色節奏的成果,因為 Kling Avatar 會完全複製音訊的時間點。

    • The Herder 的台詞長達 8.75 秒,在「agreeable」之前有一個停頓,結尾較慢。
    • Eleven v3 的文字轉語音在 Free 方案中提供,每次生成 8 點數。
    • 角色對話也接受您自行錄製的 mp3、wav、m4a、ogg 或 aac 檔案。
    00:09
    Jaime Yao 執導的《The Herder》 · Eleven v3
  4. 第 4 步

    執行角色對話

    將靜態圖像附加為角色圖像,將台詞附加為音訊,選擇 Kling AI Avatar v2 或 Kling AI Avatar v2 Pro,並在想要控制表情時新增提示詞。

    • Jaime 執行了 Kling AI Avatar v2 Pro,提示詞留空,因此臉部僅跟隨語音變化。
    • 片段長度為 8.8 秒,與台詞長度相同,因為 Character Dialogue 會根據音訊長度製作片段。
    • Character Dialogue 適用於 Standard 方案(每月 $20 美元),按音訊秒數計費。

    開啟 The Herder 工作流程

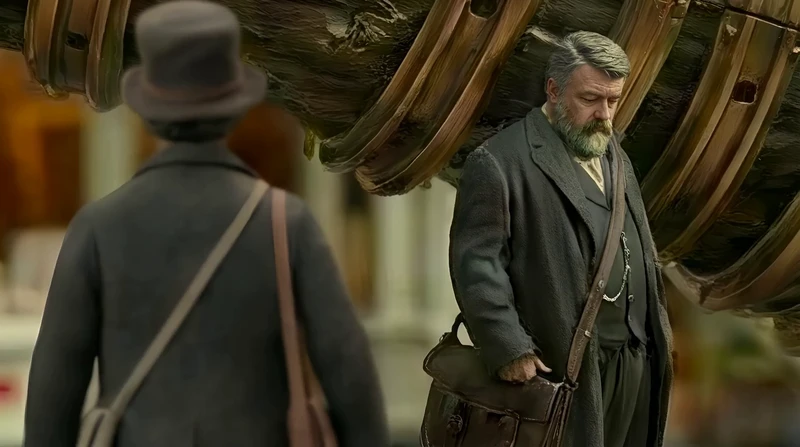
    The grey-bearded man speaks the greeting with his head lowered under the brass-ringed trunk, lip synced by Kling Avatar v2 Pro00:09
    Jaime Yao 執導的《The Herder》 · Kling AI Avatar v2 Pro
更多細節:我們如何解讀場景

本頁面所有提示詞均逐字複製自公開的 The Herder 畫布,讀取日期為 2026-10-27。計數包含該畫布上生成的媒體,包括已封存的版本。畫布未記錄 Character Dialogue 片段使用了哪張圖片;步驟 1 中的畫面與片段的構圖完全吻合,且為 8 個視訊版本的起始畫面。語音台詞的文字從音訊中讀取。此問候語並未出現在 Flick TV 上播放的 4:27 剪輯版影片中。

製作一段對嘴同步台詞需要什麼?

一句問候語經過了 11 個視訊版本(來自兩個視訊模型)和一條語音台詞,最後才由一個 Character Dialogue 片段以預先設定好的語音說出。
公開的 The Herder 畫布上為銅環樹幹下的問候語生成的媒體,讀取日期為 2026-10-27
內容數量製作工具
場景的視訊版本11Kling 3.0 Pro 10、Seedance 1.5 Pro 1
完整引用台詞的版本6Kling 3.0 Pro 5、Seedance 1.5 Pro 1
語音台詞1Eleven v3
對嘴同步片段1Kling AI Avatar v2 Pro

是什麼讓 Kling 對嘴同步看起來正確?

在畫面之前先確定聲音和台詞,挑選適合整句台詞的靜態畫面,並將對嘴鏡頭僅用於說話部分。
  1. 1. 在靜態畫面中選擇姿勢

    挑選角色說話時應有的樣貌畫格,因為 Kling Avatar 會在靜態畫面中的臉部位置進行動畫處理,而《牧羊人》中的男子在說完整句台詞時一直低著頭。

  2. 2. 先製作音訊

    在影片之前先確定聲音素材,因為音訊決定了片段的長度和每個嘴型,而新的錄音意味著需要重新對嘴。

  3. 3. 在影片提示詞中鎖定台詞

    當使用 Kling 影片模型來配音時,告訴它只說引號內的台詞,這樣嘴型才不會跟著改寫後的台詞。

    Do not add any extra words. Speak exactly the quoted lines only.
    Jaime Yao 執導的《The Herder》
    含義:要求只說引述的台詞,不添加其他文字。
  4. 4. 保持閉口直到合適的時機

    說明說話開始的時間點以及說什麼內容,這樣角色就不會在面向說話對象之前就開始說話。

    Man A’s mouth stays closed until after he has fully raised his head and made eye contact toward Man B.
    Jaime Yao 執導的《The Herder》
    含義:男子A抬頭與男子B對視後才開口說話。
  5. 5. 在提示詞中引導表情

    使用 Character Dialogue 的選用提示詞來設定表情和力度,而非台詞內容,因為台詞已經來自音訊。

    His breathing and facial tension should make the line feel effortful, almost like speaking takes work.
    Jaime Yao 執導的《Ulysses》
    含義:他說話時呼吸和面部緊繃顯示出費力感。
  6. 6. 將說話和動作分開

    為台詞單獨設置對嘴鏡頭,將握手和走路留給影片片段,因為《牧羊人》中將兩者合併到一個鏡頭的拍攝必須同時兼顧聲音和動作。

關於 Kling AI 對嘴同步的問題

什麼是 Kling AI 對嘴同步?

Kling AI 對嘴同步是快手讓角色的嘴部和臉部隨著說話同步移動的方式。在 Flick 中它以 Character Dialogue 的形式運行,使用 Kling Avatar 模型,可以將單張靜態影像依據您附加的音訊台詞進行動畫處理。

如何使用 Kling AI 讓圖片進行唇形同步?

在 Flick 中開啟角色對話,將圖片附加為角色圖像,並將一段語音附加為音訊,然後選擇 Kling AI Avatar v2 或 Kling AI Avatar v2 Pro。結果會是一段與音訊長度相同的影片,臉部會說出該段語音。

Kling AI 唇形同步是免費的嗎?

使用 Kling Avatar 模型的角色對話需要 Flick 的 Standard 方案,每月 $20,並按音訊的秒數計費。使用文字轉語音和 Eleven v3 製作台詞則在 Free 方案中提供。

Kling Avatar v2 和 v2 Pro 有什麼區別?

兩者都能將靜態圖片動畫化並配上音訊台詞,同時保持角色的外觀;Kling AI Avatar v2 Pro 是進階版本,具有更多細節,每秒音訊的成本也更高。The Herder 使用了 Pro 模型來製作其問候語。

Kling 可以唇形同步我自己的聲音嗎?

可以。錄製台詞並以 mp3、wav、m4a、ogg 或 aac 檔案上傳,然後將其附加為角色對話中的音訊。角色會以您準確的文字和時間點說話。

對話應該使用 Kling Avatar 還是 Kling 3.0?

當語音和文字必須準確時,在角色對話中使用 Kling Avatar;當角色還需要在說話時走動、做手勢或隨鏡頭移動時,使用 Kling 影片模型(例如 Kling 3.0 Pro)。許多場景兩者都使用:一個影片片段用於動作,一個唇形同步片段用於台詞。

Kling AI 可以唇形同步影片而不是圖片嗎?

Flick 中的角色對話從靜態圖像開始,而非影片。要讓移動鏡頭說話,可以從中擷取一幀作為靜態圖片,或將台詞寫入圖片轉影片的提示詞中,使用能製作聲音的 Kling 模型。

更多關於在 Flick 中讓角色說話的資訊

本指南中的影片

本頁面上的每個鏡頭都來自公開的 The Herder 畫布,並歸功於其電影製作人 Jaime Yao,除了引用自 Ulysses 的一個提示詞,也是由 Jaime Yao 製作。

為您的角色添加一句台詞

配音台詞、選擇畫面,讓 Kling 同步嘴形,所有鏡次都在同一個畫布上完成。

在 Flick 中讓角色說話

免費試用,無需信用卡。

讓 AI 解讀本頁:ChatGPTPerplexityClaude