Kling AI 립싱크는 대사가 중요해지기 전까지는 쉬워 보입니다: 인용된 대사를 말하도록 요청받은 비디오 모델은 단어를 바꾸거나, 멈춤을 서두르거나, 매 테이크마다 캐릭터에게 새로운 목소리를 줄 수 있습니다. Flick에서 Kling의 립싱크 모델은 Kling Avatar이며, Character Dialogue로 실행되고, 목소리를 생성하는 대신 당신이 선택한 녹음에서 가져옵니다. 우리는 Jaime Yao의 4:27 미니어처 단편 The Herder의 대화 씬 하나를 공개 캔버스에서 만들어진 11개의 비디오 테이크와 1개의 음성 대사를 통해 추적했습니다. 이 가이드는 정지 프레임에서 말하는 장면까지의 네 단계를 각각의 정확한 프롬프트와 함께 보여줍니다.
음성을 생성하기 전에 구두점과 멈춤을 포함하여 대사를 그대로 작성하면, 음성 테이크와 영상 프롬프트 모두 동일한 대본을 기반으로 작업할 수 있습니다.
Jaime는 먼저 Kling 3.0 Pro에게 더 긴 액션 안에서 대사를 말하도록 요청했습니다: 위를 보고, 인사하고, 악수하고, 걸어가는 것입니다.
이 씬의 Kling 3.0 Pro 테이크 5개와 Seedance 1.5 Pro 테이크 1개는 "인용된 대사만 정확히 말하세요."로 대사를 정확히 인용합니다.
이와 같은 테이크는 비디오 모델이 만든 립싱크이므로, 음성은 모델이 선택한 것입니다.
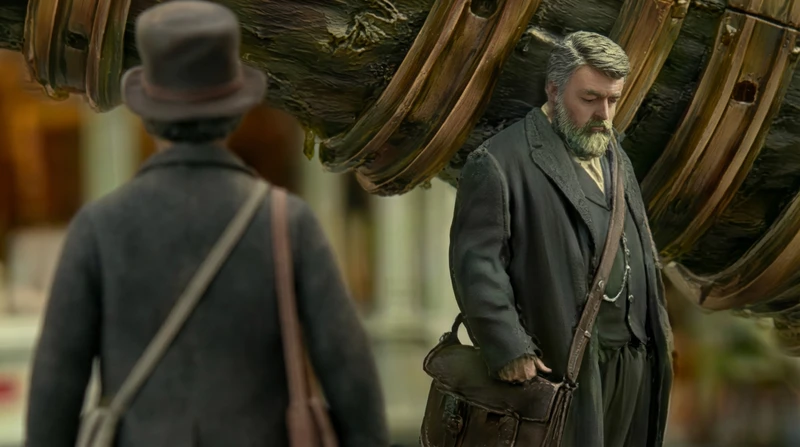
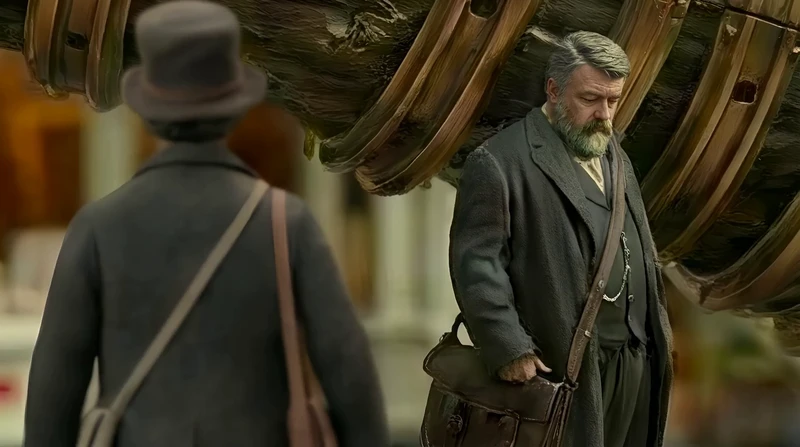
첫 프레임00:10
Jaime Yao 감독의 The Herder · Kling 3.0 Pro · 이미지를 영상으로
Same miniature diorama street and shallow macro depth of field, soft daylight. The fallen diagonal tree trunk wrapped in thin brass rings remains fixed in the background.

Man A (heavyset, gray beard, dark long coat, leather satchel) starts with head lowered and silent.
Man B (slimmer, worn dark coat, round top hat, cross-body bags, wooden walking stick) is approaching from behind the camera, mostly back-facing. From the very first frame, Man B is already walking forward at a steady pace (continuous walking, no pause, no hesitation), entering the scene from behind the camera.

Man A first lifts his head, looks directly toward Man B, and only then begins speaking. Man A speaks clearly in English with visible lip-sync, saying:

“Ah, Tuner Kagran. At last.
I trust your journey was… agreeable.
Ours, regrettably, has not been.”

Action sequence (one continuous shot):

Man A’s mouth stays closed until after he has fully raised his head and made eye contact toward Man B. While speaking the lines above, Man A keeps his gaze up toward Man B and speaks with clear mouth movement and slight pauses matching the punctuation.

Man B keeps walking forward during the speech and arrives near Man A.

After the final line, Man A steps forward and extends his left hand.

They shake hands once using their left hands only (firm but brief). Man B keeps the walking stick in his right hand during the handshake.

Immediately after the handshake, Man A turns his body toward the fallen trunk and gestures forward, then begins walking to lead Man B toward the trunk.

Man B follows alongside, holding the walking stick, as they approach the trunk together.

Keep the environment unchanged. No camera movement. No new characters. This scene has a very handheld feel. Do not add any extra words. Speak exactly the quoted lines only.
의미:미니어처 거리 배경에서 회색 수염의 남자가 뒤에서 오는 지팡이 든 남자에게 말하고 악수한 후 함께 통나무로 걸어갑니다.
3단계
대사 음성 생성
Eleven v3의 텍스트 음성 변환으로 대사를 생성하거나 직접 녹음하고, 캐릭터에 맞는 속도의 테이크를 선택하세요. Kling Avatar가 오디오 타이밍을 정확히 복사합니다.
The Herder의 대사는 8.75초 동안 진행되며, "agreeable" 앞에 멈춤이 있고 끝부분은 더 느립니다.
Eleven v3의 텍스트 음성 변환은 Free 플랜에서 생성당 8 크레딧으로 이용할 수 있습니다.
캐릭터 대화는 mp3, wav, m4a, ogg 또는 aac 파일 형식의 직접 녹음도 받습니다.
이 페이지의 모든 프롬프트는 2026-10-27에 읽은 공개 The Herder 캔버스에서 그대로 복사한 것입니다. 개수는 보관된 테이크를 포함하여 해당 캔버스에서 생성된 미디어를 기준으로 합니다. 캔버스는 Character Dialogue 클립이 어떤 이미지에서 만들어졌는지 기록하지 않습니다. 1단계의 프레임은 클립의 프레이밍과 정확히 일치하며, 8개의 비디오 테이크의 시작 프레임입니다. 음성 대사의 단어는 오디오에서 읽습니다. 인사는 Flick TV에 표시된 영화의 4:27 편집본에는 없습니다.
립싱크된 한 줄의 대사를 만드는 데 무엇이 필요했나요?
하나의 인사말은 두 개의 비디오 모델에서 11개의 비디오 테이크와 하나의 음성 대사를 거친 후, 단일 Character Dialogue 클립이 미리 정해진 음성으로 말했습니다.
2026-10-27에 읽은 공개 The Herder 캔버스에서 황동 테두리 트렁크 아래 인사말을 위해 생성된 미디어
항목
개수
제작 도구
씬의 비디오 테이크
11
Kling 3.0 Pro 10, Seedance 1.5 Pro 1
대사를 정확히 인용한 테이크
6
Kling 3.0 Pro 5, Seedance 1.5 Pro 1
음성 대사
1
Eleven v3
립싱크된 클립
1
Kling AI Avatar v2 Pro
Kling 립싱크를 자연스럽게 보이게 하는 요소는 무엇인가요?
그림보다 먼저 음성과 대사를 확정하고, 전체 대사에 어울리는 스틸을 선택하며, 립싱크 샷은 말하는 부분에만 사용하세요.
1. 스틸에서 포즈 선택하기
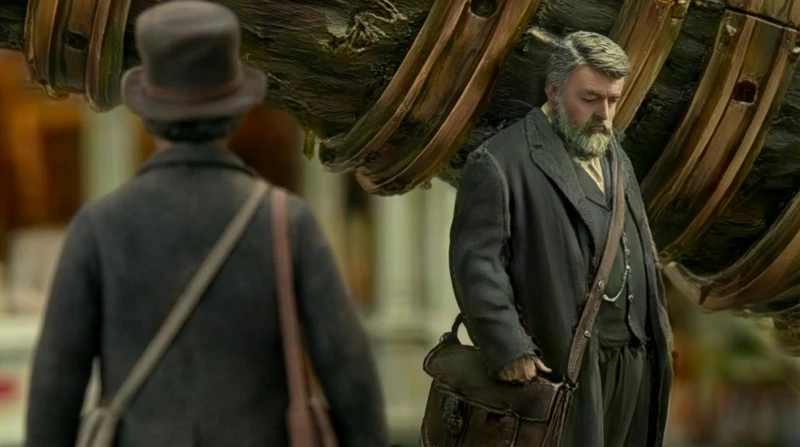
캐릭터가 말할 때 어떻게 보여야 할지를 위한 프레임을 선택하세요. Kling Avatar는 스틸 이미지에서 얼굴이 있는 위치를 기준으로 애니메이션을 적용하기 때문입니다. The Herder의 남자는 고개를 숙인 채로 전체 대사를 말합니다.
2. 오디오를 먼저 제작하기
비디오보다 먼저 음성 테이크를 확정하세요. 오디오가 클립의 길이와 모든 입 모양을 결정하므로, 새로운 테이크는 새로운 립싱크를 의미합니다.
3. 비디오 프롬프트에 대사 고정하기
Kling 비디오 모델이 대신 대사를 말할 때는, 인용된 단어만 말하고 다른 것은 말하지 않도록 지시하여 입술이 다시 표현된 대사를 따르지 않도록 하세요.
Do not add any extra words. Speak exactly the quoted lines only.
대사에는 전용 립싱크 샷을 주고 악수나 걷기는 비디오 클립에 맡기세요. The Herder의 테이크에서 두 가지를 한 샷에 담으려다 보니 음성과 움직임을 동시에 맞춰야 했기 때문입니다.
Kling AI 립싱크에 관한 질문
Kling AI 립싱크란 무엇인가요?
Kling AI 립싱크는 Kuaishou가 캐릭터의 입과 얼굴을 말에 맞춰 움직이게 만드는 방식입니다. Flick에서는 Character Dialogue로 실행되며, Kling Avatar 모델을 사용하여 사용자가 첨부한 오디오 대사에 맞춰 하나의 스틸 이미지를 애니메이션화합니다.
Kling AI로 사진에 립싱크를 적용하려면 어떻게 하나요?
Flick에서 Character Dialogue를 열고, 사진을 Character Image로 첨부하고 음성 대사를 Audio로 첨부한 다음, Kling AI Avatar v2 또는 Kling AI Avatar v2 Pro를 선택하세요. 결과는 오디오 길이만큼의 비디오로, 얼굴이 대사를 말하는 모습이 나옵니다.
Kling AI 립싱크는 무료인가요?
Kling Avatar 모델을 사용하는 Character Dialogue는 Flick의 Standard 플랜(월 $20)이 필요하며, 오디오 초당 요금이 청구됩니다. Text to Voice와 Eleven v3로 대사를 만드는 것은 Free 플랜에서 가능합니다.
Kling Avatar v2와 v2 Pro의 차이점은 무엇인가요?
두 모델 모두 정지 이미지를 오디오 대사에 맞춰 애니메이션화하고 캐릭터의 외형을 유지합니다. Kling AI Avatar v2 Pro는 더 디테일한 프리미엄 버전으로 오디오 초당 비용이 더 높습니다. The Herder는 인사말에 Pro 모델을 사용했습니다.
Kling으로 내 목소리를 립싱크할 수 있나요?
네. 대사를 녹음하고 mp3, wav, m4a, ogg 또는 aac 파일로 업로드한 다음, Character Dialogue에서 Audio로 첨부하세요. 캐릭터가 정확한 단어와 타이밍으로 말합니다.
대사에 Kling Avatar와 Kling 3.0 중 무엇을 사용해야 하나요?
목소리와 단어가 정확해야 할 때는 Character Dialogue에서 Kling Avatar를 사용하고, 캐릭터가 말하면서 걷거나 제스처를 취하거나 카메라와 함께 움직여야 할 때는 Kling 3.0 Pro 같은 Kling 비디오 모델을 사용하세요. 많은 씬에서 두 가지를 모두 사용합니다: 액션용 비디오 클립과 대사용 립싱크 클립.
Kling AI로 사진 대신 비디오를 립싱크할 수 있나요?
Flick의 Character Dialogue는 비디오가 아닌 정지 이미지에서 시작합니다. 움직이는 장면에 대사를 추가하려면, 정지 이미지로 프레임을 추출하거나, 소리를 만드는 Kling 모델의 Image to Video 프롬프트에 대사를 작성하세요.

 00:09