비디오를 위한 AI 보이스오버: 단편 영화 내레이션 만드는 법
AI 보이스오버를 위해, 내레이션을 각 촬영 컷에 맞는 짧은 대사로 작성하고, AI 음성 모델로 각각을 녹음한 뒤, 가장 좋은 테이크를 선택해 영상 아래에 배치하세요.
작성자 Zoey Z.최종 업데이트

대부분의 AI 보이스오버 도구는 스크립트를 하나의 긴 오디오 파일로 변환하는데, 이는 설명 영상에는 적합하지만 스토리를 평평하게 만듭니다. 스토리에서는 각 대사가 적절한 촬영 컷에 맞춰 들어가고 다음 컷 전에 끝나야 하기 때문입니다. 영화를 위한 내레이션은 각각의 순간을 위해 작성되고 개별적으로 녹음된 별도의 대사로 작업하는 것이 더 효과적입니다. 우리는 Flick 팀의 Zoey Zhang이 제작한 1분 38초 애니메이션 단편 'To My Grandma'를 따라갔습니다. 이 작품의 전체 스토리는 Text to Voice로 녹음된 6개의 대사로 내레이터가 전달합니다. 이 가이드는 해당 영화의 실제 대사, 테이크, 타이밍을 사용하여 비디오용 AI 보이스오버를 네 단계로 만드는 방법을 보여줍니다.
비디오를 위한 AI 보이스오버란 무엇인가요?
- Flick에서는 Text to Voice가 Eleven v3, Eleven v4 또는 Seed Audio 1.0으로 내레이션을 만들고, Video Editor가 이를 촬영 컷 아래에 배치합니다.
- 보이스오버는 들리지만 보이지 않습니다: 캐릭터가 카메라 앞에서 입술을 움직이며 말해야 할 때는 토킹 샷이며, 이는 AI 토킹 아바타 가이드에서 다룹니다.
실제 단편 영화는 AI 내레이션을 어떻게 사용하나요?
| 대사 | 시작 시간 | 테이크 |
|---|---|---|
My grandma, when I think of her, somehow I always remember her from behind. | 0:00 | 3 |
She would always secretly tuck food into my hands. | 0:21 | 2 |
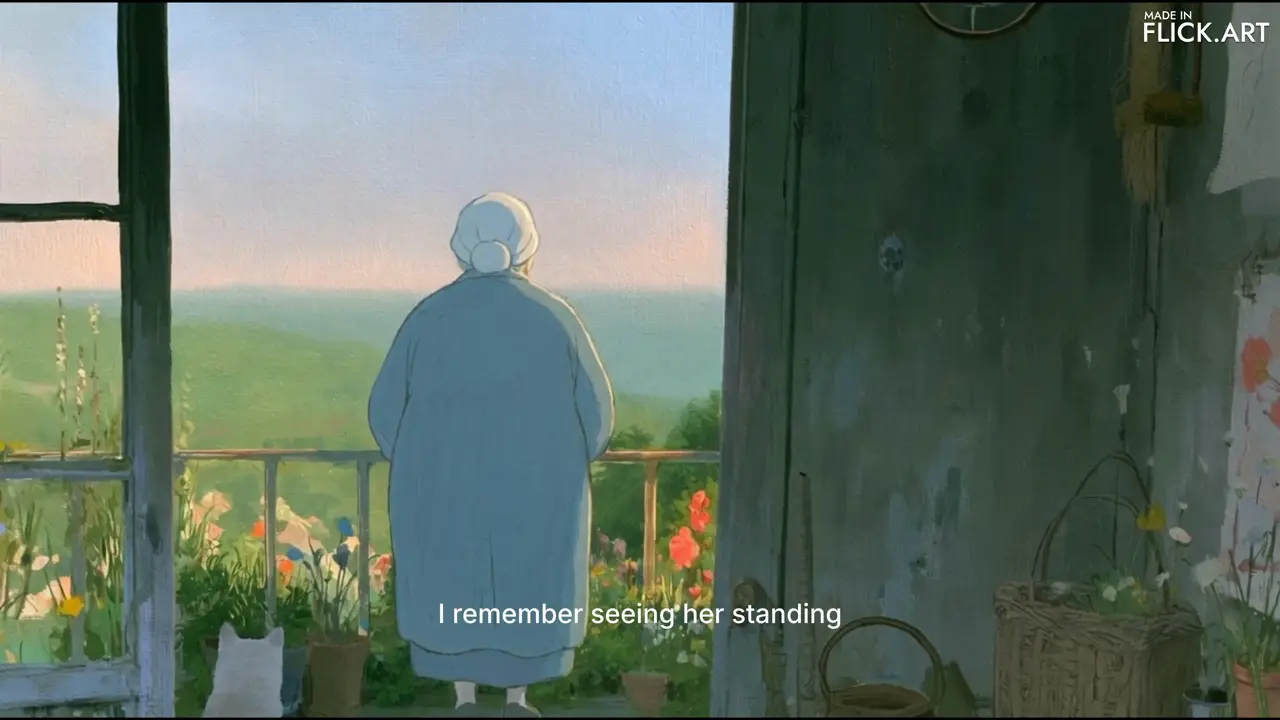
I remember seeing her standing alone on the balcony, lost in thought. I sometimes wonder if she was thinking of grandpa. | 0:38 | 1 |
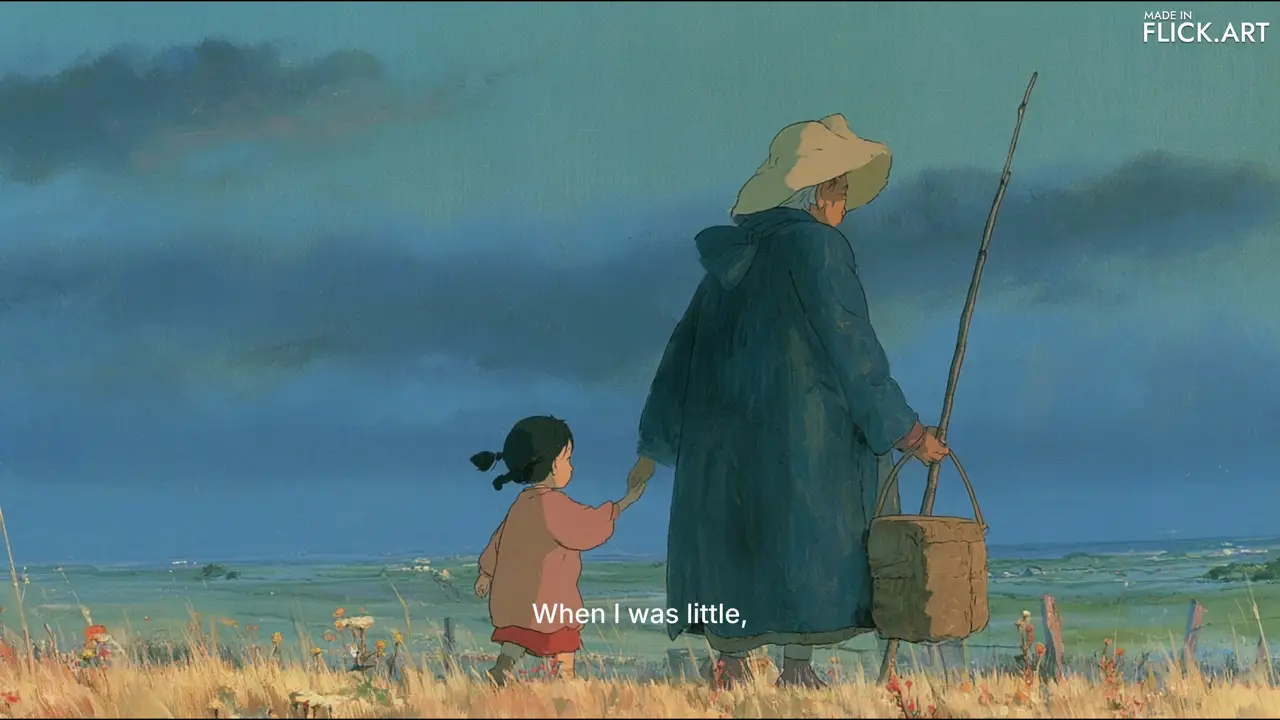
When I was little, she would always hold my hand tightly, afraid that I might get lost. | 0:48 | 1 |
But as I grew older, our hands slowly let go of each other. | 0:56 | 1 |
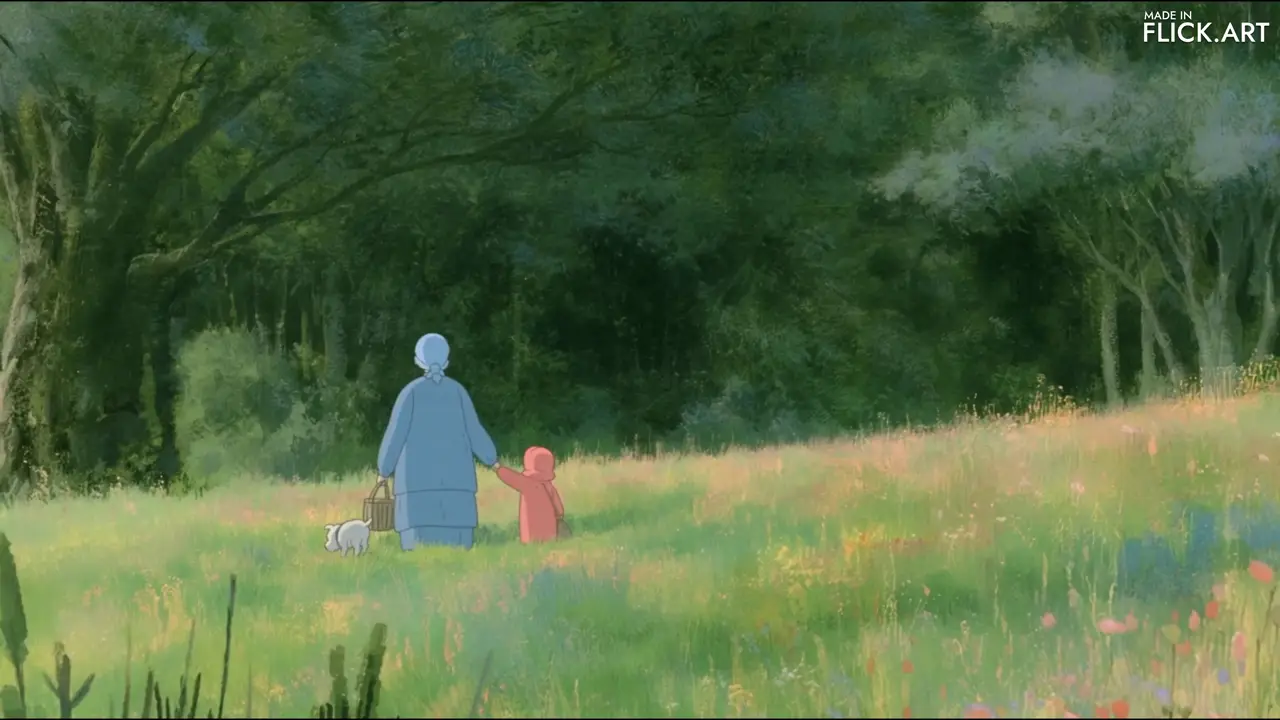
But I wish I could go back to when I was little, when you held my hand so tightly. Now, when I reach out to hold yours again, there's nothing left for me to hold. | 1:19 | 2 |
- 모든 테이크는 Eleven v3로 만들어졌으며, 각 대사는 하나의 생성이므로 나머지 부분을 건드리지 않고 한 대사만 다시 만들 수 있습니다.
- 마지막 대사는 "her"에서 "you"로 바뀌는데, 제목처럼 할머니 자신에게 직접 말하는 유일한 대사입니다.
비디오에 AI 보이스오버를 추가하는 단계별 방법은?
1단계
샷을 위한 대사 작성
각 순간마다 한두 문장을 작성하고, 각 대사가 샷으로 보여줄 수 없는 것을 말하게 하세요. 화면을 그저 묘사하는 내레이터는 화면을 반복할 뿐입니다.
- 발코니에 있는 할머니 위로, 내레이션은 우리가 보는 것을 "발코니에 홀로 서서, 생각에 잠겨 있다"라고 명명합니다.
- 그런 다음 어떤 화면도 담지 못하는 것을 추가합니다: "나는 때때로 그녀가 할아버지를 생각하고 있었는지 궁금하다."
- 편집본에 맞춰 대사를 소리 내어 읽어보세요. 대사가 샷을 넘어가면 그 이후의 모든 대사가 늦어집니다.
 00:09
Zoey Z. 감독의 To My Grandma · 0:38 2단계
각 대사를 음성으로 만들기
Text to Voice를 열고 내레이터를 위한 음성을 하나 선택한 다음 생성당 한 줄씩 입력하세요. 그러면 각 줄이 이동, 자르기 또는 재생성할 수 있는 개별 오디오 클립이 됩니다.
- "내가 어렸을 때, 할머니는 내가 길을 잃을까 봐 항상 내 손을 꼭 잡곤 하셨다."라는 대사는 4.6초 길이의 Eleven v3 생성 1개이며, 세 개의 샷에 걸쳐 배치되어 있습니다.
- Eleven v3 또는 Eleven v4를 사용한 Text to Voice는 Free 플랜에서 생성당 8 크레딧으로 이용할 수 있습니다.
- [whispers]나 [dramatic pause]와 같이 대괄호 안의 지시어는 대사를 어떻게 읽을지 안내합니다.
 00:05
Zoey Z. 감독의 To My Grandma · 0:48 3단계
최고의 테이크 선택하기
속도나 느낌이 맞지 않을 때는 대사를 다시 생성하여 테이크를 나란히 비교하세요. 같은 단어라도 매번 더 빠르게, 느리게 또는 따뜻하게 생성될 수 있습니다.
- 여기서 들을 수 있는 마지막 대사는 캔버스에 9.6초와 8.8초의 두 가지 테이크가 있습니다.
- 첫 번째 대사에는 5.0초, 5.6초, 6.0초의 세 가지 테이크가 있습니다.
- 나머지 네 개의 대사 중 음식을 챙겨주는 대사에는 두 개의 테이크가 있고 나머지는 각각 하나씩입니다.
 00:14
Zoey Z. 감독의 To My Grandma · 1:19 4단계
침묵을 위한 공간 남기기
Video Editor에서 각 대사를 해당 샷 아래에 배치하고 내레이션이 없는 구간을 남겨두세요. 그러면 대사 사이의 순간들을 영상과 음악이 전달하게 됩니다.
- 첫 번째 대사가 끝난 후, To My Grandma는 할머니가 부엌에서 졸고 있는 장면과 같은 샷들로 약 16초 동안 아무 말 없이 진행됩니다.
- 두 번째 대사는 0:21에 시작되며, 영상은 할머니가 소녀의 손에 음식을 챙겨주는 장면으로 전환됩니다.
- Video Editor에서 오디오는 Music 트랙에 위치하며, 각 대사는 자체 볼륨과 페이드를 가집니다.
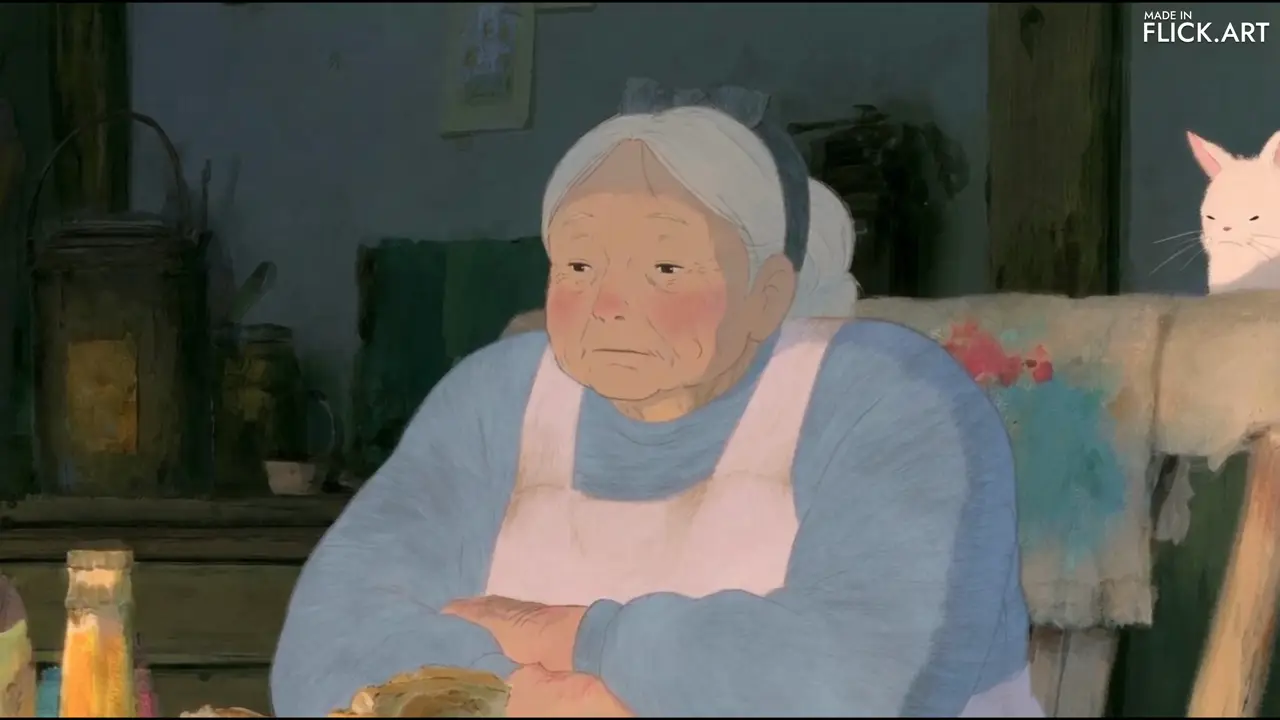 00:10
Zoey Z. 감독의 To My Grandma · 0:15
더 자세히: 우리가 영화를 읽는 방법
이 대사들은 영화의 오디오와 Text to Voice 클립에서 전사된 것입니다. Text to Voice 클립의 텍스트는 공개 캔버스에 표시되지 않기 때문입니다. 시작 시간은 각 대사의 Text to Voice 클립이 Flick TV에 게시된 영화에서 위치한 지점으로, 클립의 사운드를 영화의 사운드와 매칭하고 영화의 자막과 대조하여 확인한 후 초 단위로 반올림한 것입니다. 이 페이지에서 재생되는 순간들은 해당 영화에서 사운드와 함께 편집된 것입니다. Takes는 공개된 To My Grandma 캔버스에서 생성된 Text to Voice 클립으로, 2026-10-27에 읽은 것이며 보관된 것도 포함됩니다. 음악과 같은 업로드된 오디오는 포함되지 않습니다.
AI 보이스오버를 자연스럽게 만드는 요소는 무엇인가요?
1. 영상이 담지 못하는 것을 추가하세요
Use the narration for thought, memory and feeling, as To My Grandma wonders whether the grandmother "was thinking of grandpa" over a shot of her back.2. 각 대사를 짧게 유지하세요
Write lines a listener takes in at once, as the 6 lines of To My Grandma do, the longest of them two sentences.3. 쉼을 위해 구두점을 사용하세요
Put a comma or a full stop where the voice should breathe, because the voice model pauses at punctuation rather than at line breaks you imagine.4. 생성당 한 줄씩
Voice each line on its own, so a weak read is redone alone and every line can be moved to fit the cut.5. 영상이 숨 쉴 여유를 주세요
Leave whole shots without narration, as the film does for about 16 seconds after its opening line, so the voice never sounds like a running commentary.6. 반전은 마지막을 위해 남겨두세요
Keep the change in the narrator's voice for the last line, as To My Grandma shifts from "she" to "you" in the line where the narrator reaches for her grandmother's hand.
비디오용 AI 보이스오버에 대한 질문들
AI 보이스오버란 무엇인가요?
AI 보이스오버는 녹음 세션 대신 작성된 텍스트로 만들어진 생성된 음성이 말하는 내레이션입니다. 화면에 등장하는 캐릭터가 말하는 대사와 달리, 내레이터의 목소리로 비디오 위에 얹어집니다.
비디오에 AI 보이스오버를 추가하는 방법은 무엇인가요?
내레이션을 짧은 대사로 작성하고, 각 대사를 텍스트 음성 변환 모델로 생성한 다음, 비디오 편집기에서 오디오 클립을 장면 아래에 배치합니다. Flick에서는 Text to Voice가 대사를 만들고 Video Editor의 Music 트랙이 영상 아래에 보관합니다.
무료 AI 비디오 보이스오버가 있나요?
네. Flick의 Text to Voice는 Eleven v3 또는 Eleven v4로 Free 플랜에서 생성당 8 크레딧으로 이용할 수 있으며, 신규 계정은 가입 시 100 크레딧을 받습니다.
내 목소리로 AI 보이스오버를 만들 수 있나요?
네. Flick에서 Seed Audio 1.0을 사용한 Text to Voice는 최대 3개의 음성 클립을 레퍼런스로 첨부하여 해당 목소리로 새로운 대사를 말할 수 있습니다. 자신의 녹음을 오디오로 가져와 타임라인에 배치할 수도 있습니다. 사용 권한이 있는 목소리만 사용하세요.
단편 영화에서 내레이션은 얼마나 길어야 하나요?
스토리가 허용하는 한 짧게: 내레이션은 연속된 트랙이 아니라 그 사이에 침묵이 있는 몇 줄의 대사로 사용할 때 가장 효과적입니다. Flick에서 제작된 단편 영화 To My Grandma는 1분 38초의 영화에서 6개의 내레이션 대사로 스토리를 전달합니다.
AI 보이스오버가 감정적으로 들릴 수 있나요?
네. Text to Voice에서 대사를 말해야 하는 방식대로 작성하고, 목소리가 멈춰야 하는 곳에 문장 부호를 넣고, [whispers]나 [laughs]와 같은 단서를 대괄호 안에 추가하세요. 여러 테이크를 생성하고 장면에 맞는 느낌의 테이크를 선택하세요.
AI 보이스오버가 다른 언어를 말할 수 있나요?
네. Eleven v4는 90개 이상의 언어를 지원하며, Text to Voice의 음성 선택 도구는 언어별로 음성을 필터링합니다. 모든 음성이 모든 언어를 지원하는 것은 아니므로 먼저 음성을 미리 들어보세요.
Flick에서 사운드와 스토리에 대한 더 많은 정보


이 페이지의 영화
- Zoey Z. · To My Grandma
- Jaime Yao · A Proper Introduction
이 페이지에서 재생되는 장면들은 완성된 To My Grandma 영화의 내레이션과 공개 캔버스의 테이크 및 타이밍에서 가져온 것이며, 두 가지 모두 영화 제작자에게 크레딧이 있습니다. 관련 카드는 To My Grandma 캔버스와 Jaime Yao의 A Proper Introduction의 장면을 보여줍니다.
영화에 내레이터 추가하기
대사를 작성하고, Text to Voice에서 음성으로 변환하고, 장면 아래에 배치하세요. 모두 하나의 캔버스에서.
무료로 사용해 보세요. 신용카드가 필요하지 않습니다.
이 페이지에 대해 AI에게 묻기:ChatGPTPerplexityClaude